整体概括: 这篇论文研究的基于传播路径的假新闻探测问题, 研究的场景是社交媒体, 以Twitter为例. 本文提出模型, 通过新闻的传播路径(最源头的推文文本信息, 转推者(retweet)的用户信息等)来做二分类问题.
论文提出的模型叫做Graph-aware Co-Attention Networks. 由此可以看出, 模型中用到了
图(graph)相关的表征模型和co-attention的机制.笔者的深度学习知识储备浅薄, 看到文章标题的第一反应是, 模型的可解释性(interpretability) 来自
co-attention机制, 而图表征的技术手段则提供了一个新的表征维度, 原文作者一定是因为其给模型带来的增益较大, 才将其作为文题. 传统而言, 假新闻的表征手段关注于表征文本(源文本, 转发文本, 评论等等), 而本文表征的是传播路径.一起来看看原文作者是怎么做的吧.
问题建模
以下根据原文
3 Problem Statement解读
前面这几行没什么好说的, 定义了两个集合, 一个推文集合, 一个用户集合, 然后用单词集合来表示每一篇推文.
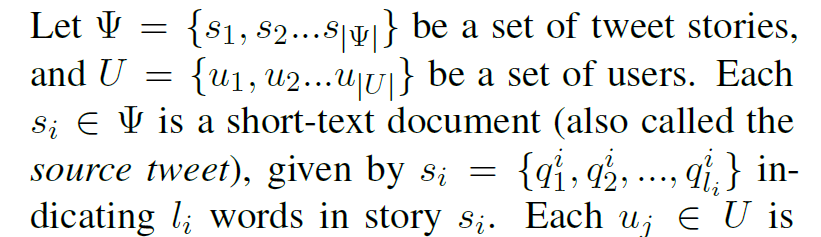
紧接着, 作者定义了用户特征和传播路径. 所谓传播路径就是
a sequence of retweet records.
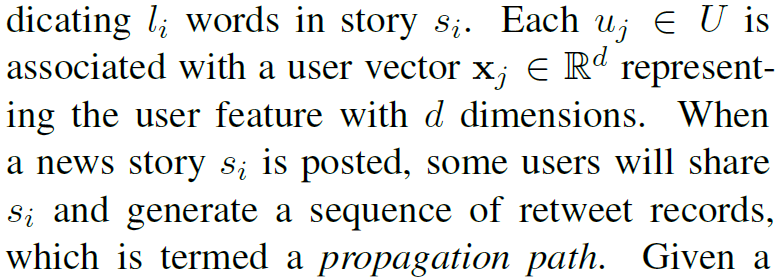
某条推特 $s_i$ 的一条传播路径 $R_i$ 由一个个包含3个元素的tuple组成. 每个tuple里包含了在 $u_j$ 这个用户,以及ta的各种属性 $x_j$ , 以及ta转发这条推特的时间 $t_j$ . 数据集里包含了 $s_i$ 的标签 fake or true, 注意到, 这个标签随着时间从 $t_1$ 变到 $t_K$ (传播路径 $R_i$ 上一共有 $K$ 个用户 ) 是保持不变的.
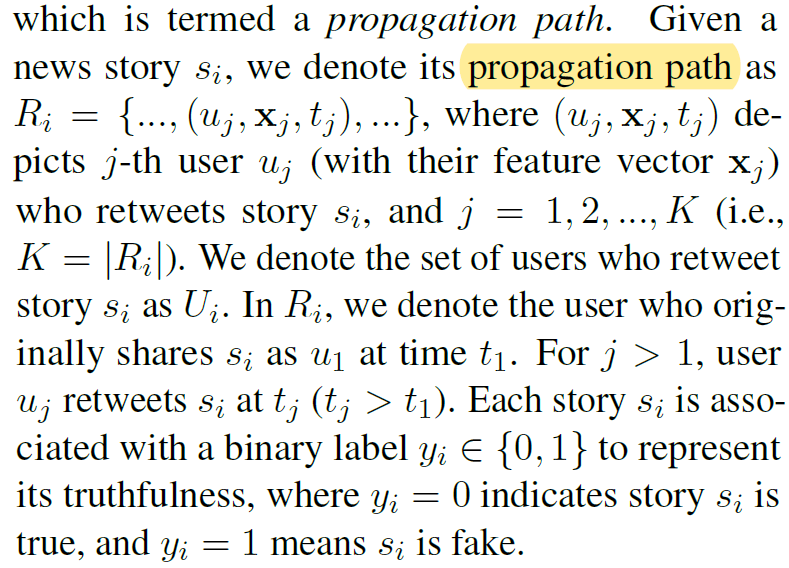
此外, 根据后文, 用户 $u_j$ 的特征 $x_j$ 主要包括:
- number of words in a user’s self-description
- number of words in $u_j$ ‘s screen name
- number of users who follows $u_j$
- number of users that $u_j$ is following
- number of created stories for $u_j$
- time elapsed after $u_j$’ s first story
- whether the $u_j$ account is verified or not
- whether $u_j$ allows the geo-spatial positioning
- time difference between the source tweet’s post time and $u_j$ ’s retweet time
- the length of retweet path between $u_j$ and the source tweet (1 if $u_j$ retweets the source tweet)
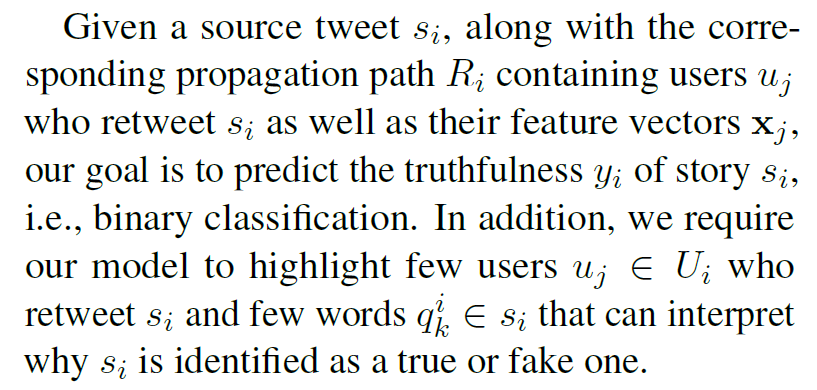
作者希望通过传播路径和原始推文来做一个二分类问题, 即原始推文是真还是假. 并且, 作者希望模型能针对假新闻的样例给人们启示:
- 找出那部分少量的可疑用户
- 找出假新闻中独特的词语
模型结构
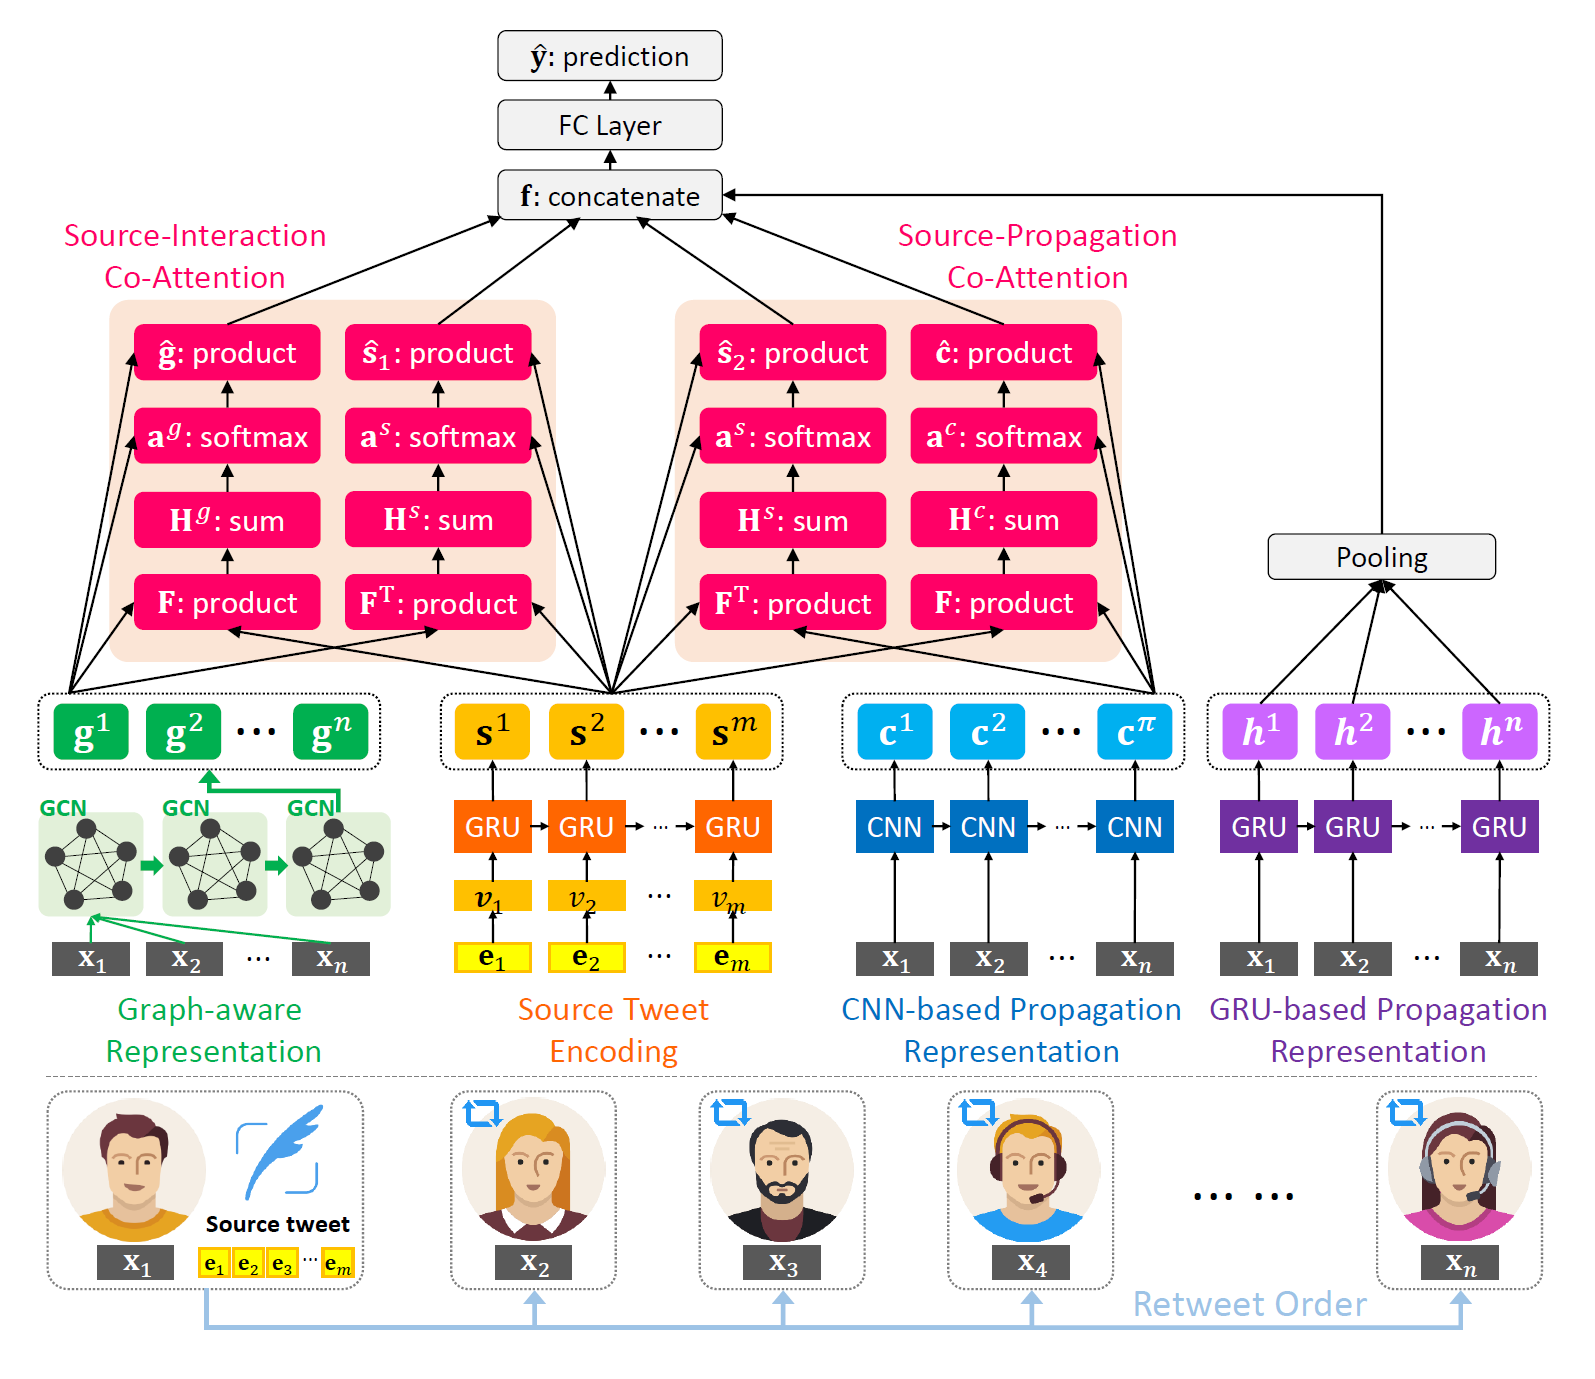
总体来说, 下面的图片概括了原文章提出的深度学习模型.
模型主要包括5个部分:
- 用户特征提取(user characteristics extraction)
- 对每个用户$u_j$ , 都能提取出特征 $x_j$ , 具体描述见上文
- 推文的表征(news story encoding) //如何翻译encoding比较好呢
- 设定文本的最大长度$m$, zero padding to maximum length
- 通过全连接层生成 $d$ 维的word embedding $V = [v_1, v_2, …, v_m]$
- 使用GRU来学习$V$里的次序特征, $s_t=GRU(v_t), t=1, …, m$
- 最终的推文表征为 $S = [s^{1}, s^{2}, …, s^{m}]\in \mathbb{R}^{d \times m}$
- 传播途径的表征
-
user propagation representation
针对传播路径 $R_i$ 中用户特征 $[x_1, …, x_j, …, x_K]$ 的处理
- GRU-based representation
- CNN-based representation (1-Dimension)
-
graph-aware propagation representation
- 全连接的图; 用户作为节点; 两个用户的相似度作为边, 通过用户的特征向量$x_i$, $x_j$ 的余弦相似度计算得出.
- 两个GCN层叠加
-
-
两个的注意力机制(co-attention mechanisms 用于捕捉
推文和传播途径之间的关系)- 原文里说的是 dual co-attention mechanism. 但是其本质上就是两个 co-attention 机制, 从下面的模型图也能看出. 一个是
source-interaction, 一个是source-propagation, 用到的信息就从下面的模型图也能一目了然. - 具体的公式推导在这里省略, 有兴趣的读者可以参考原始论文
- 原文里说的是 dual co-attention mechanism. 但是其本质上就是两个 co-attention 机制, 从下面的模型图也能看出. 一个是
-
预测(make prediction)
- 对于每一条
(原始新闻, 传播路径), 把上述的5个向量拼接起来, 就是最终的特征向量 $f$ . 然后使用全连接层做二分类.
- 对于每一条
实验结果
实验设计
这部分在本文里略过
实验结果
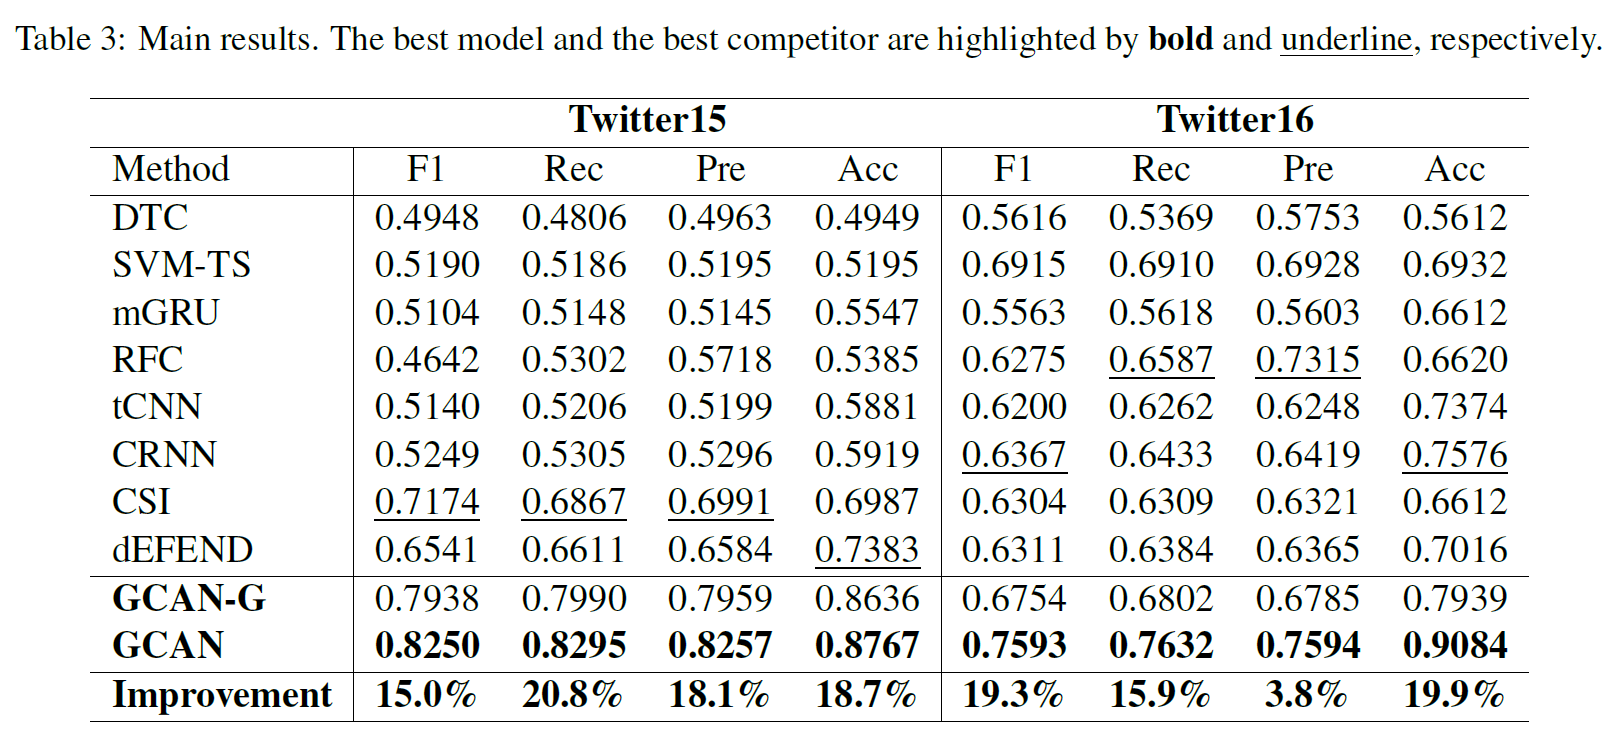
通过和一众模型对比, 可以看出原文里提出的GCAN模型的performance有很大的提升.
上表中的GCAN-G模型是GCAN去掉了GCN那一块之后的模型, 那么显然, 去掉了用户之间的互动信息, 也就去掉了后面的source-interaction co-attention (也有可能没去掉, 可能是用$[x_1, …, x_j, …, x_n]$ 直接feed到source-interaction co-attention里, 但是这样也失去了interaction的含义).
早期探测
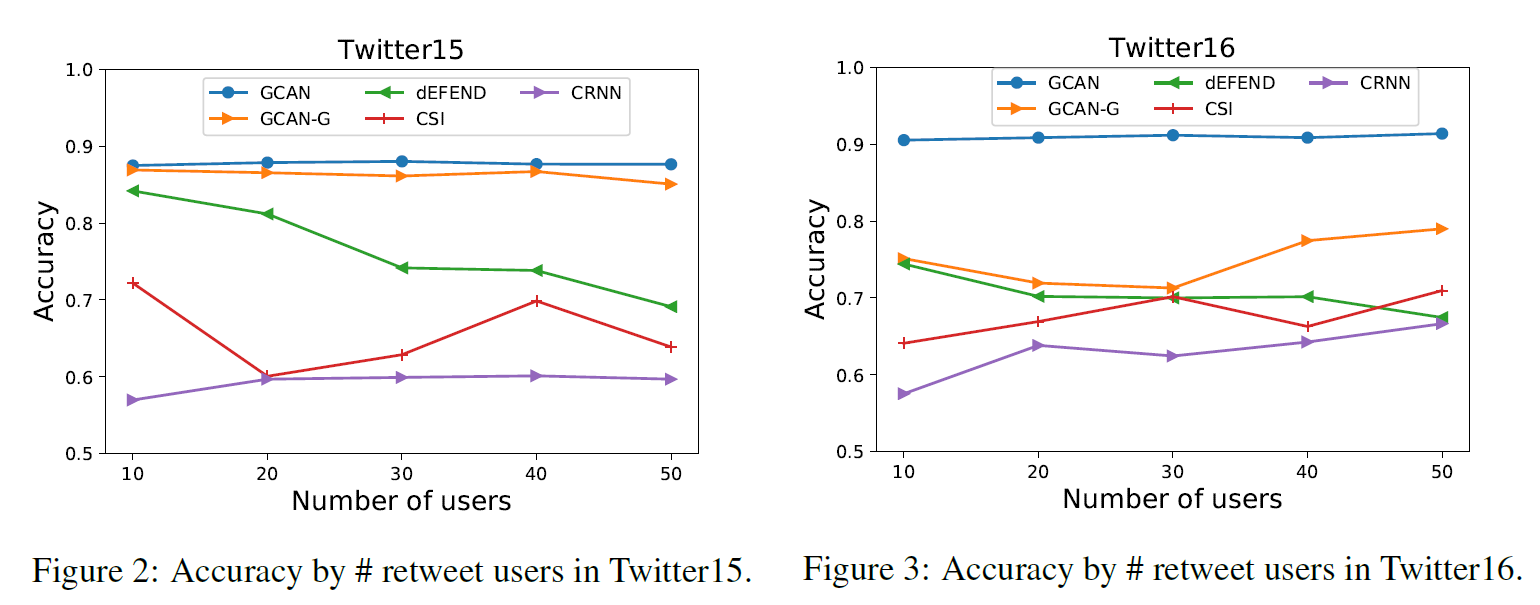
下图是在Twitter15和Twitter16两个数据集上的结果, 展示了传播链条的长度对模型预测精度的影响. 可以看出转发人数从50减少到10, 意味着传播链条的长度在缩短, 而GCAN的模型表现并没有太大的变化. 这意味着GCAN可以做到假新闻的早期探测(early detection)
消融实验
结论: 模型的几个模块都是有贡献的
可解释性
关于博客一开始提到的可解释性, 论文作者也从模型的角度给出了一些见解.
值得注意的是, GCAN模型的可解释性主要来自source-propagation co-attention 的权重, 因为经过了GCN 的处理, 用户的interaction 特征不好解读, 所以 source-interaction co-attention 的权重没有被用到.
原推的文本
下图是原论文作者举的例子:
假新闻: “breaking: ks patient at risk for ebola: in strict isolation at ku med center in kansas city #kwch12”
真新闻: “confirmed: this is irrelevant. rt @ks-dknews: confirmed: #mike-brown had no criminal record. #ferguson”
词云展示了假新闻和真新闻在用词上的不同. 字体越大的词, 代表着co-attention weights越大
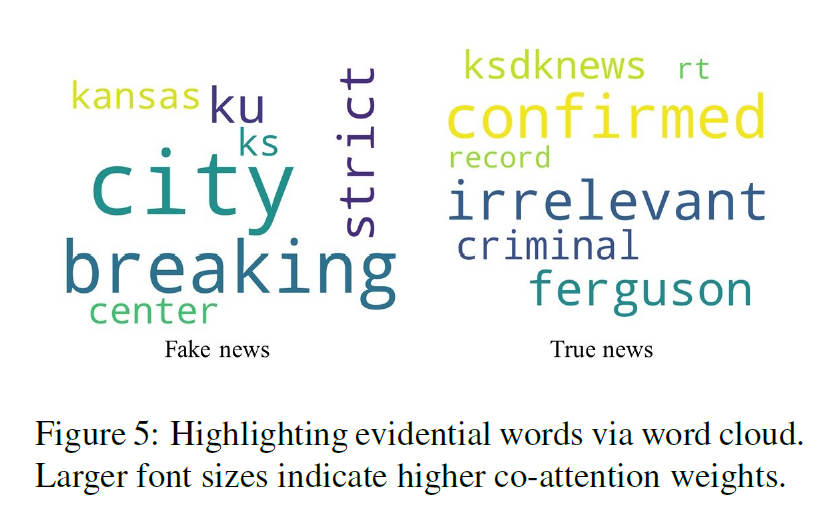
可以看出, GCAN predicts the former to be fake with stronger attention on words “breaking” and “strict”, and detects the latter as real since it contains “confirmed” and “irrelevant.”
传播链条
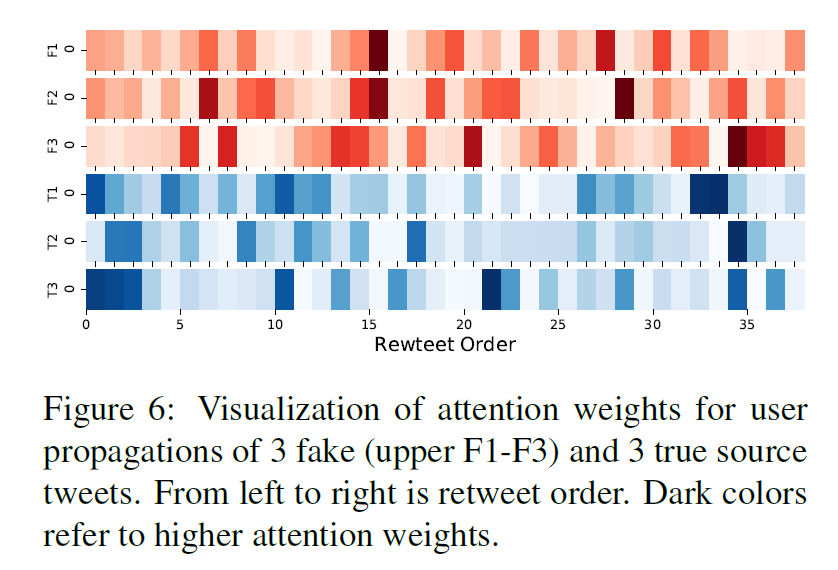
下面这张图里, 作者展示了3条假新闻, 3条真新闻的 source-propagation co-attention. 根据这张图, 作者指出检查最开始转发的那几个用户, 是一个判断新闻真假的好办法( 对假新闻而言, 在传播路径的前段, 转发者的权重比较小; 而对真新闻而言, 在传播路径的前段, 转发者的权重比较大)
转发者的特征
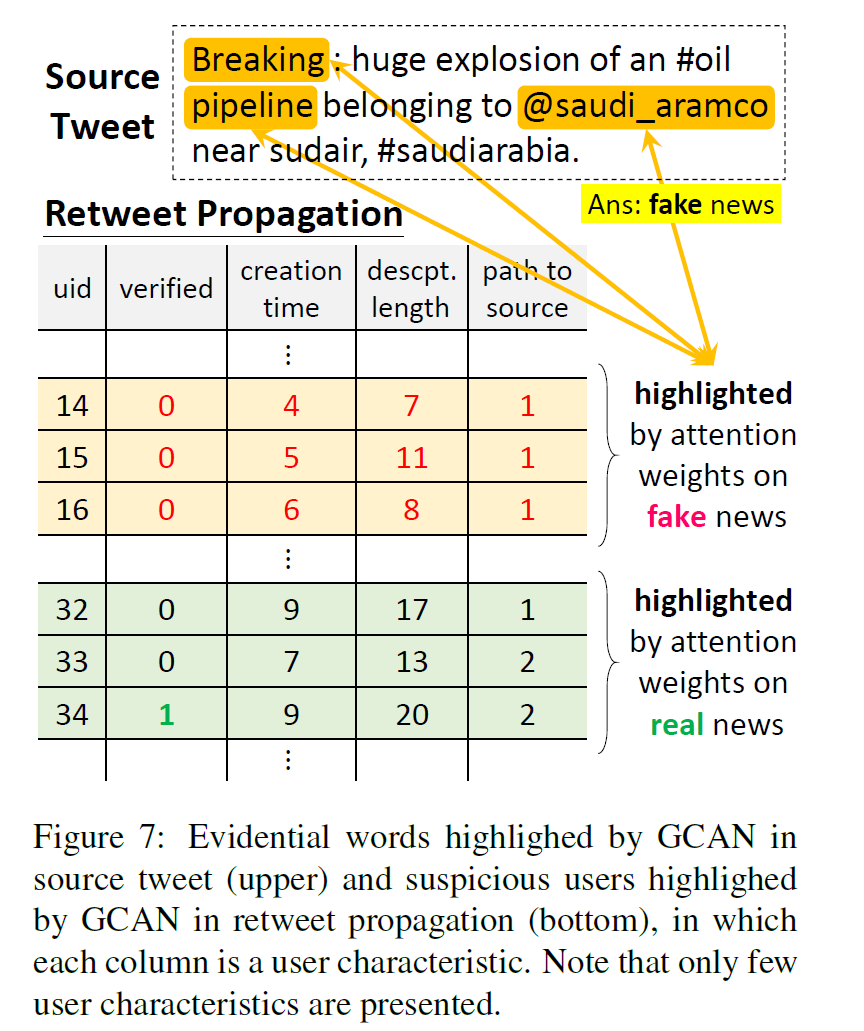
这部分的可解释性同样来自 source-propagation co-attention. 参见下面这张图, 根据 source-propagation co-attention 权重的大小, 可以挑选出一些用户特征的维度, 也可以挑选出一些源推特的词语. 论文作者认为, 这些词语(breaking, pipeline)可以反映新闻中隐含的立场(potential stances), 有可能对探测假新闻有用.
笔者认为 stance detection 确实是fake news detection的一个好方向.
总结
到这里为止, 笔者对这篇论文的解读就告一段落了. 接下来的事情是去 Github 上阅读这篇论文的源代码了.
用机器学习来研究假新闻的传播, 检测, 是近几年比较流行的话题. 而模型的可解释性也是我们关注得越来越多的地方.
值得一提的是, 文中提到的GCAN模型不仅可以用在假新闻探测上, 其他的社交媒体上的短文本分类任务(sentiment detection, hate speech detection, tweet popularity prediction)也可以适用.
参考
- Lu, Y.-J., & Li, C.-T. (2020). GCAN: Graph-aware Co-Attention Networks for Explainable Fake News Detection on Social Media. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics, 505–514. https://doi.org/10.18653/v1/2020.acl-main.48