本文在已有原始数据的基础上, 使用正则表达式
regular expression, 提取投资者和上市公司高管之间的有趣问答.据观察, 这种基础性的自然语言处理技巧被广泛地运用在部分财经媒体的
AI新闻模块
获取数据
东方财富网是一个庞大的财经门户网站, 里面每天都有大量的官方推送和用户生成的内容.
我们的教程也从东方财富网开始.
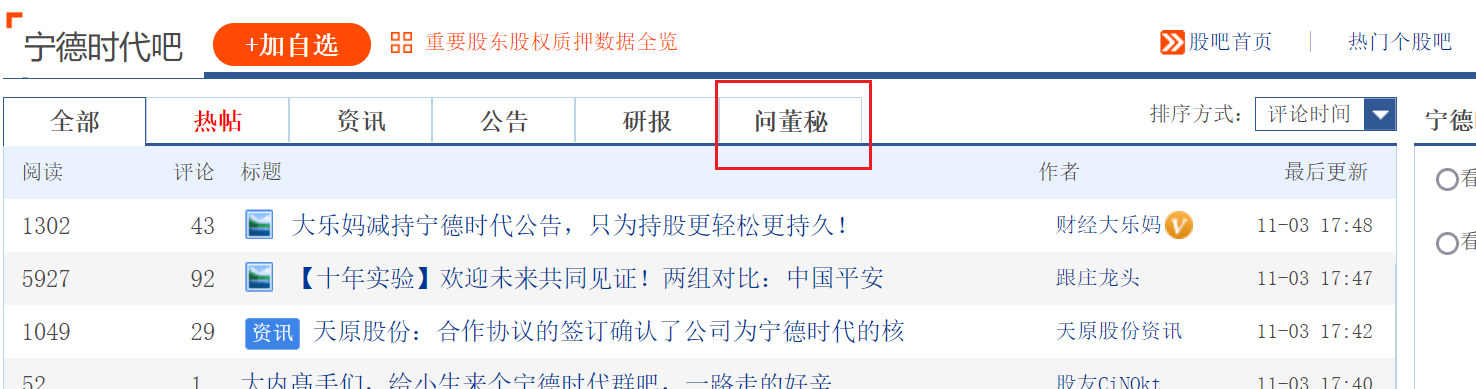
在东方财富的网站上搜索某家股票, 点进结果, 拉到最下, 就能看到如下的某家股票吧. 下图展示了”宁德时代”的页面. 可以看到, 在最右边一栏有问董秘板块, 点进去之后就是投资者和上市公司之间的各种奇葩对话了.
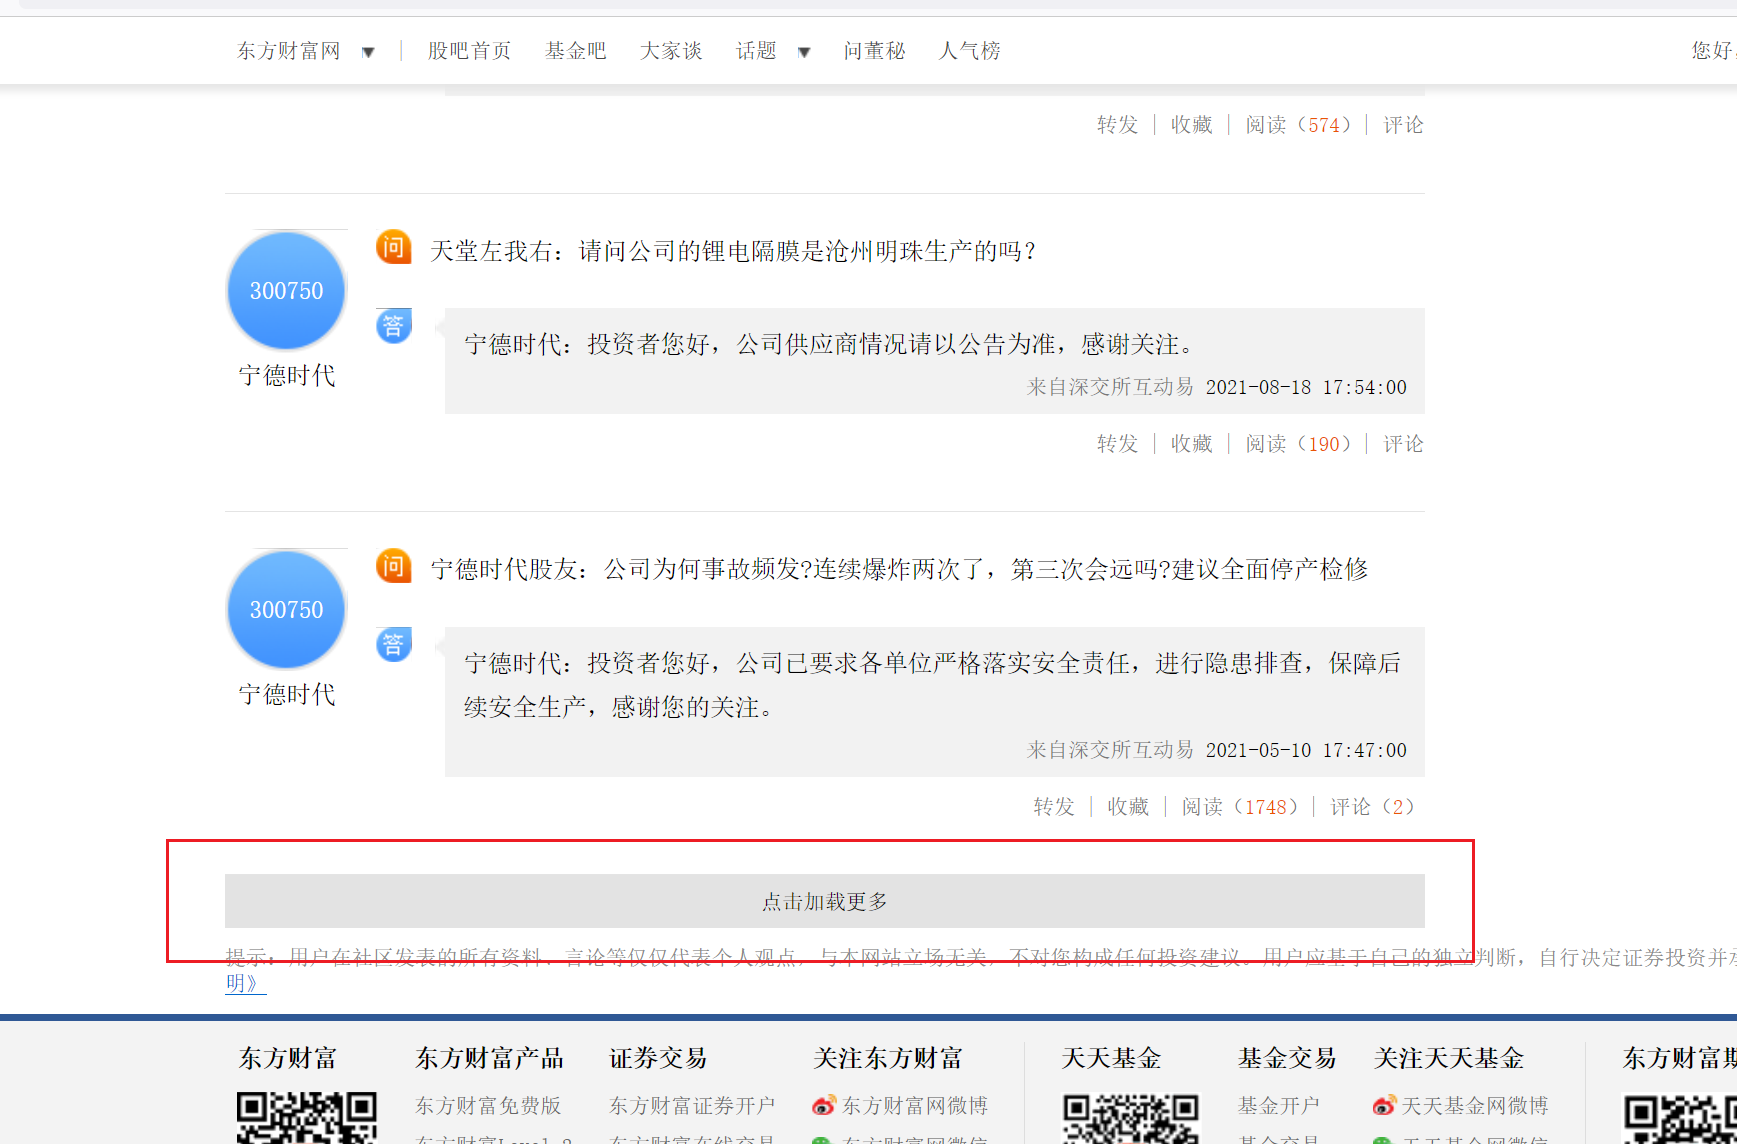
假设我们还没有掌握爬虫技巧, 那么我们想做的事情就是多次点击页面中的点击加载更多, 让页面展示了足够多的问答数据之后, 再右键-查看网页源代码.
在一个新弹出的页面里面, 我们可以看到一些html代码, 我们按ctrl+A将它们全部选中, 然后复制, 粘贴到一个记事本文件里, 保存成data.txt
有了数据, 接下来就能开始解析了.
值得一提的是, 如果引入爬虫的技术, 其本质上就是把我们人工点击点击加载更多按钮的过程交给一个机器人来做, 显然, 这样更省时省力.
把文本导入进来
一般而言, 导入一个.txt文件, 我们直接使用python的open(文件名).read()方法就可以了, 也就是html = open('./data.txt').read(). 但有的时候, 如果需要读取的文本很大, 一个更安全的做法是使用如下的做法:
with open('./data.txt') as file:
    html = file.read()
到这一步, 一个名为html的字符串类型的数据, 已经存在于我们的console里了
调试正则表达式
上帝: 没有人能一步写100%正确的正则表达式
什么是正则表达式呢?
简单地说, 正则表达式就是想用一种通用的方法来表示一批具有某种相同特征的文本. 以我们刚刚获取的html代码为例:
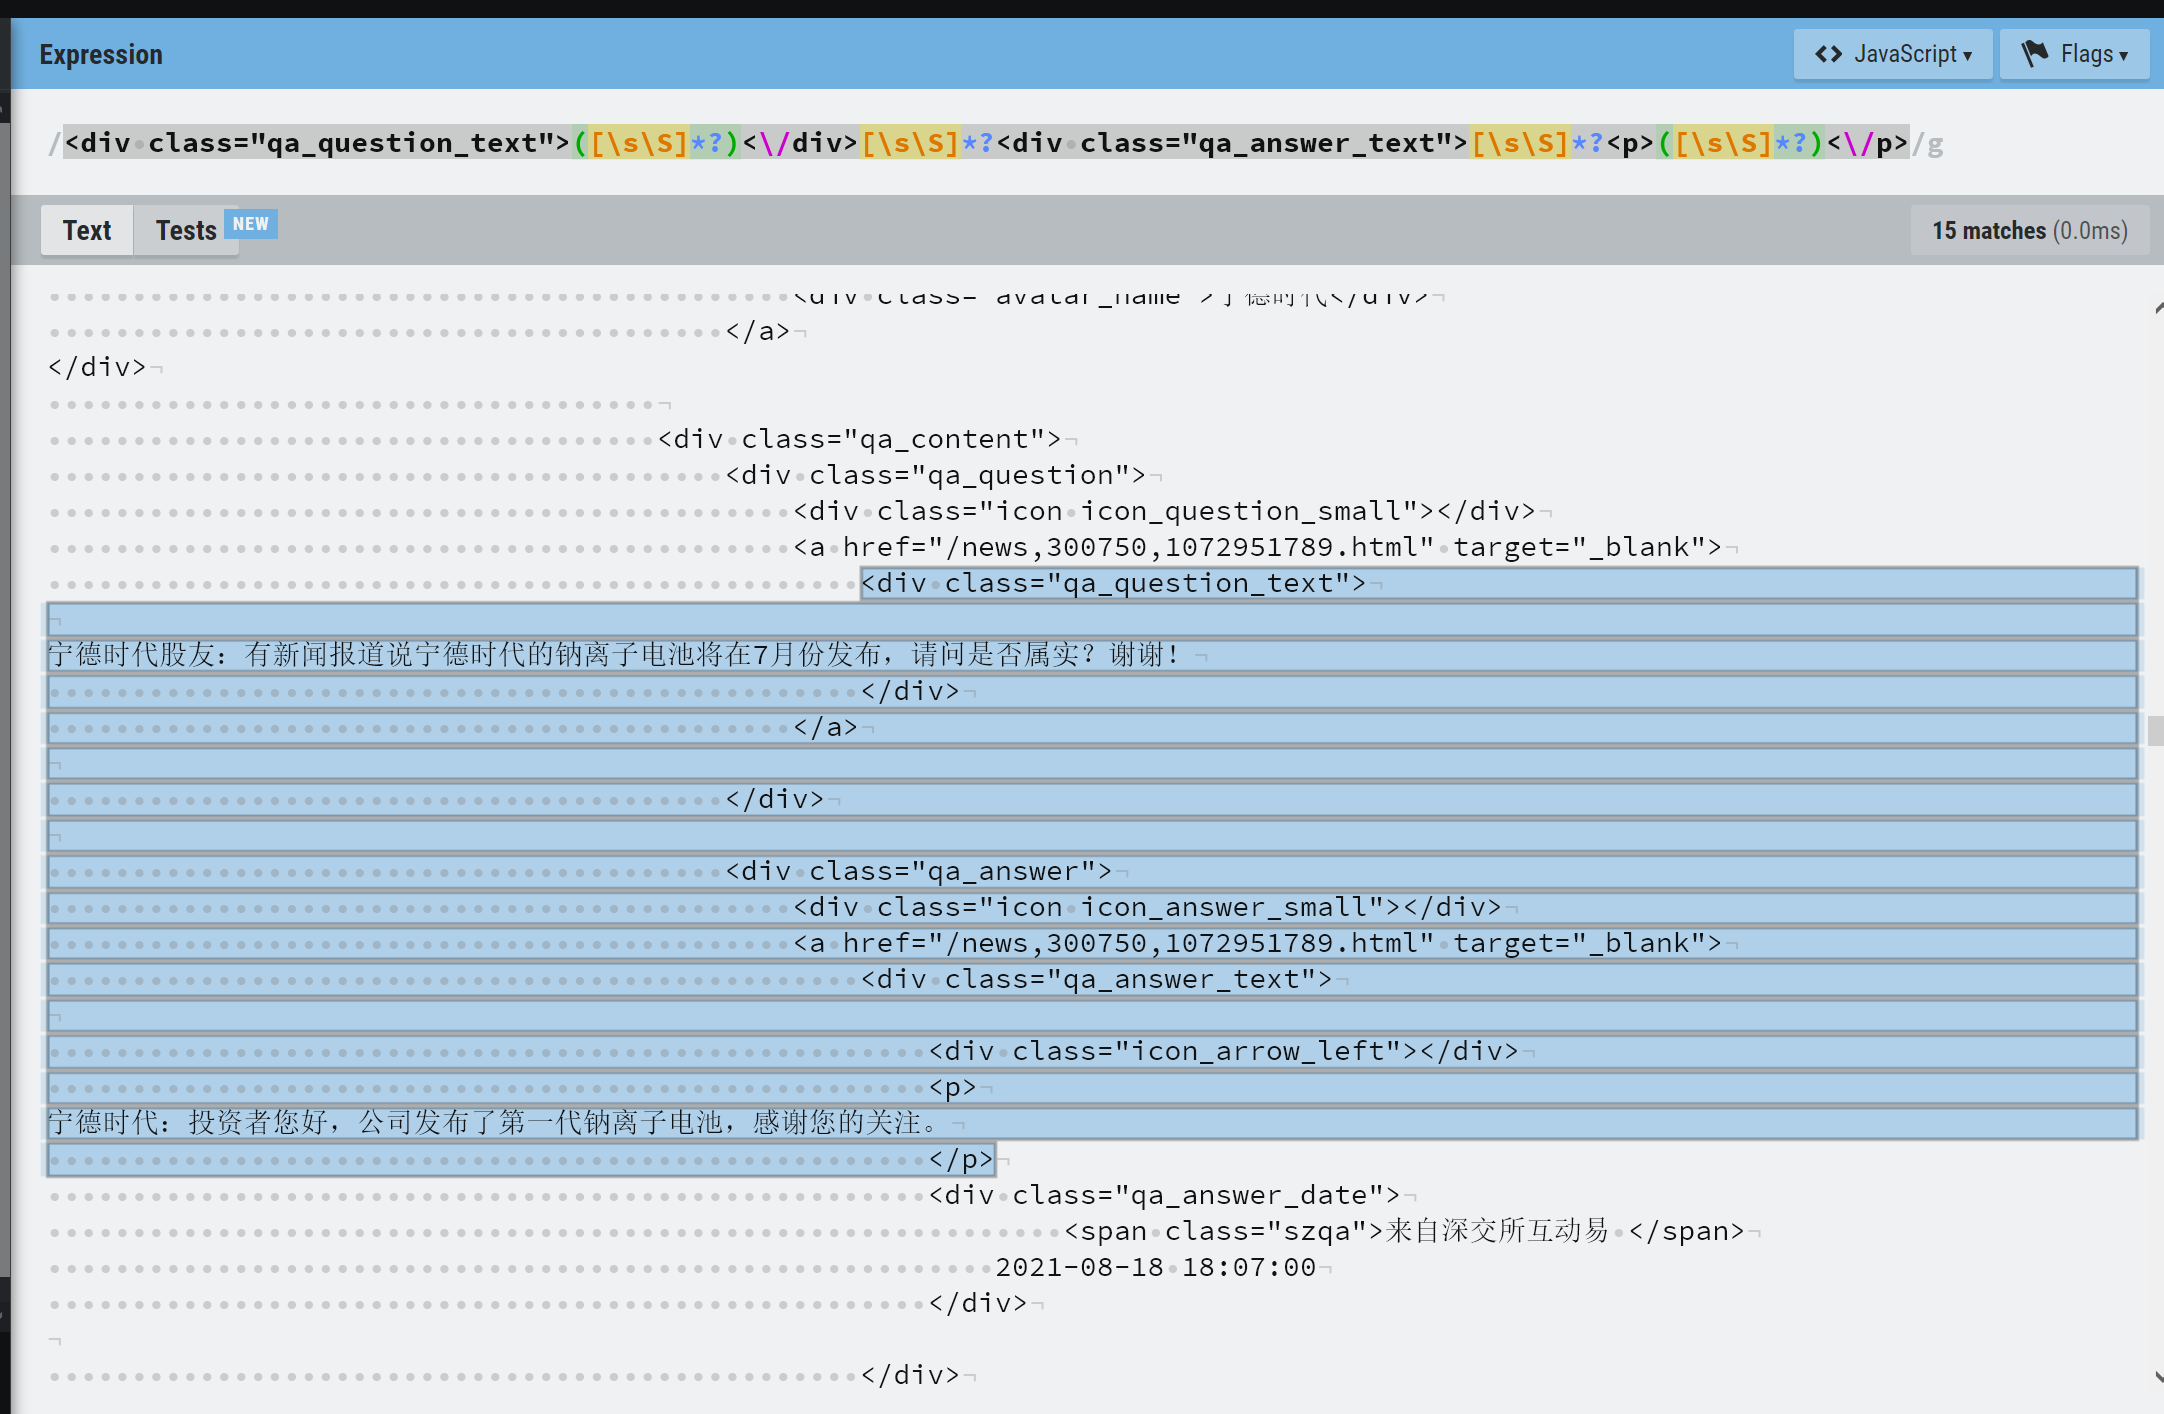
每一对宁德时代的股民与宁德时代的对话, 它们周围都有一些相似的html标记. 比如, 如果不算换行符和空格之类的干扰, <div class="qa_question_text">之后, 接的一般都是宁德时代的股民的提问; 而<div class="qa_answer_text">之后, 并不直接跟着宁德时代的回答, 而是
<div class="icon icon_answer_small"></div>
                                        <a href="/news,300750,1072951789.html" target="_blank">
                                            <div class="qa_answer_text">

                                                <div class="icon_arrow_left"></div>
                                                <p>
这样一些乱七八糟的html标记.
我们找到了宁德时代的股民与宁德时代的对话的”规律”!
对了, 上面那张截图是在这个网站截取的. 上帝说”没有人能一步写好100%正确的正则表达式”, 但是https://regexr.com/给我们提供了一个便捷地调试正则表达式的platform.
究竟什么是正则表达式
我们今天要写的正则表达式长这样: <div class="qa_question_text">([\s\S]*?)<\/div>[\s\S]*?<div class="qa_answer_text">[\s\S]*?<p>([\s\S]*?)<\/p>
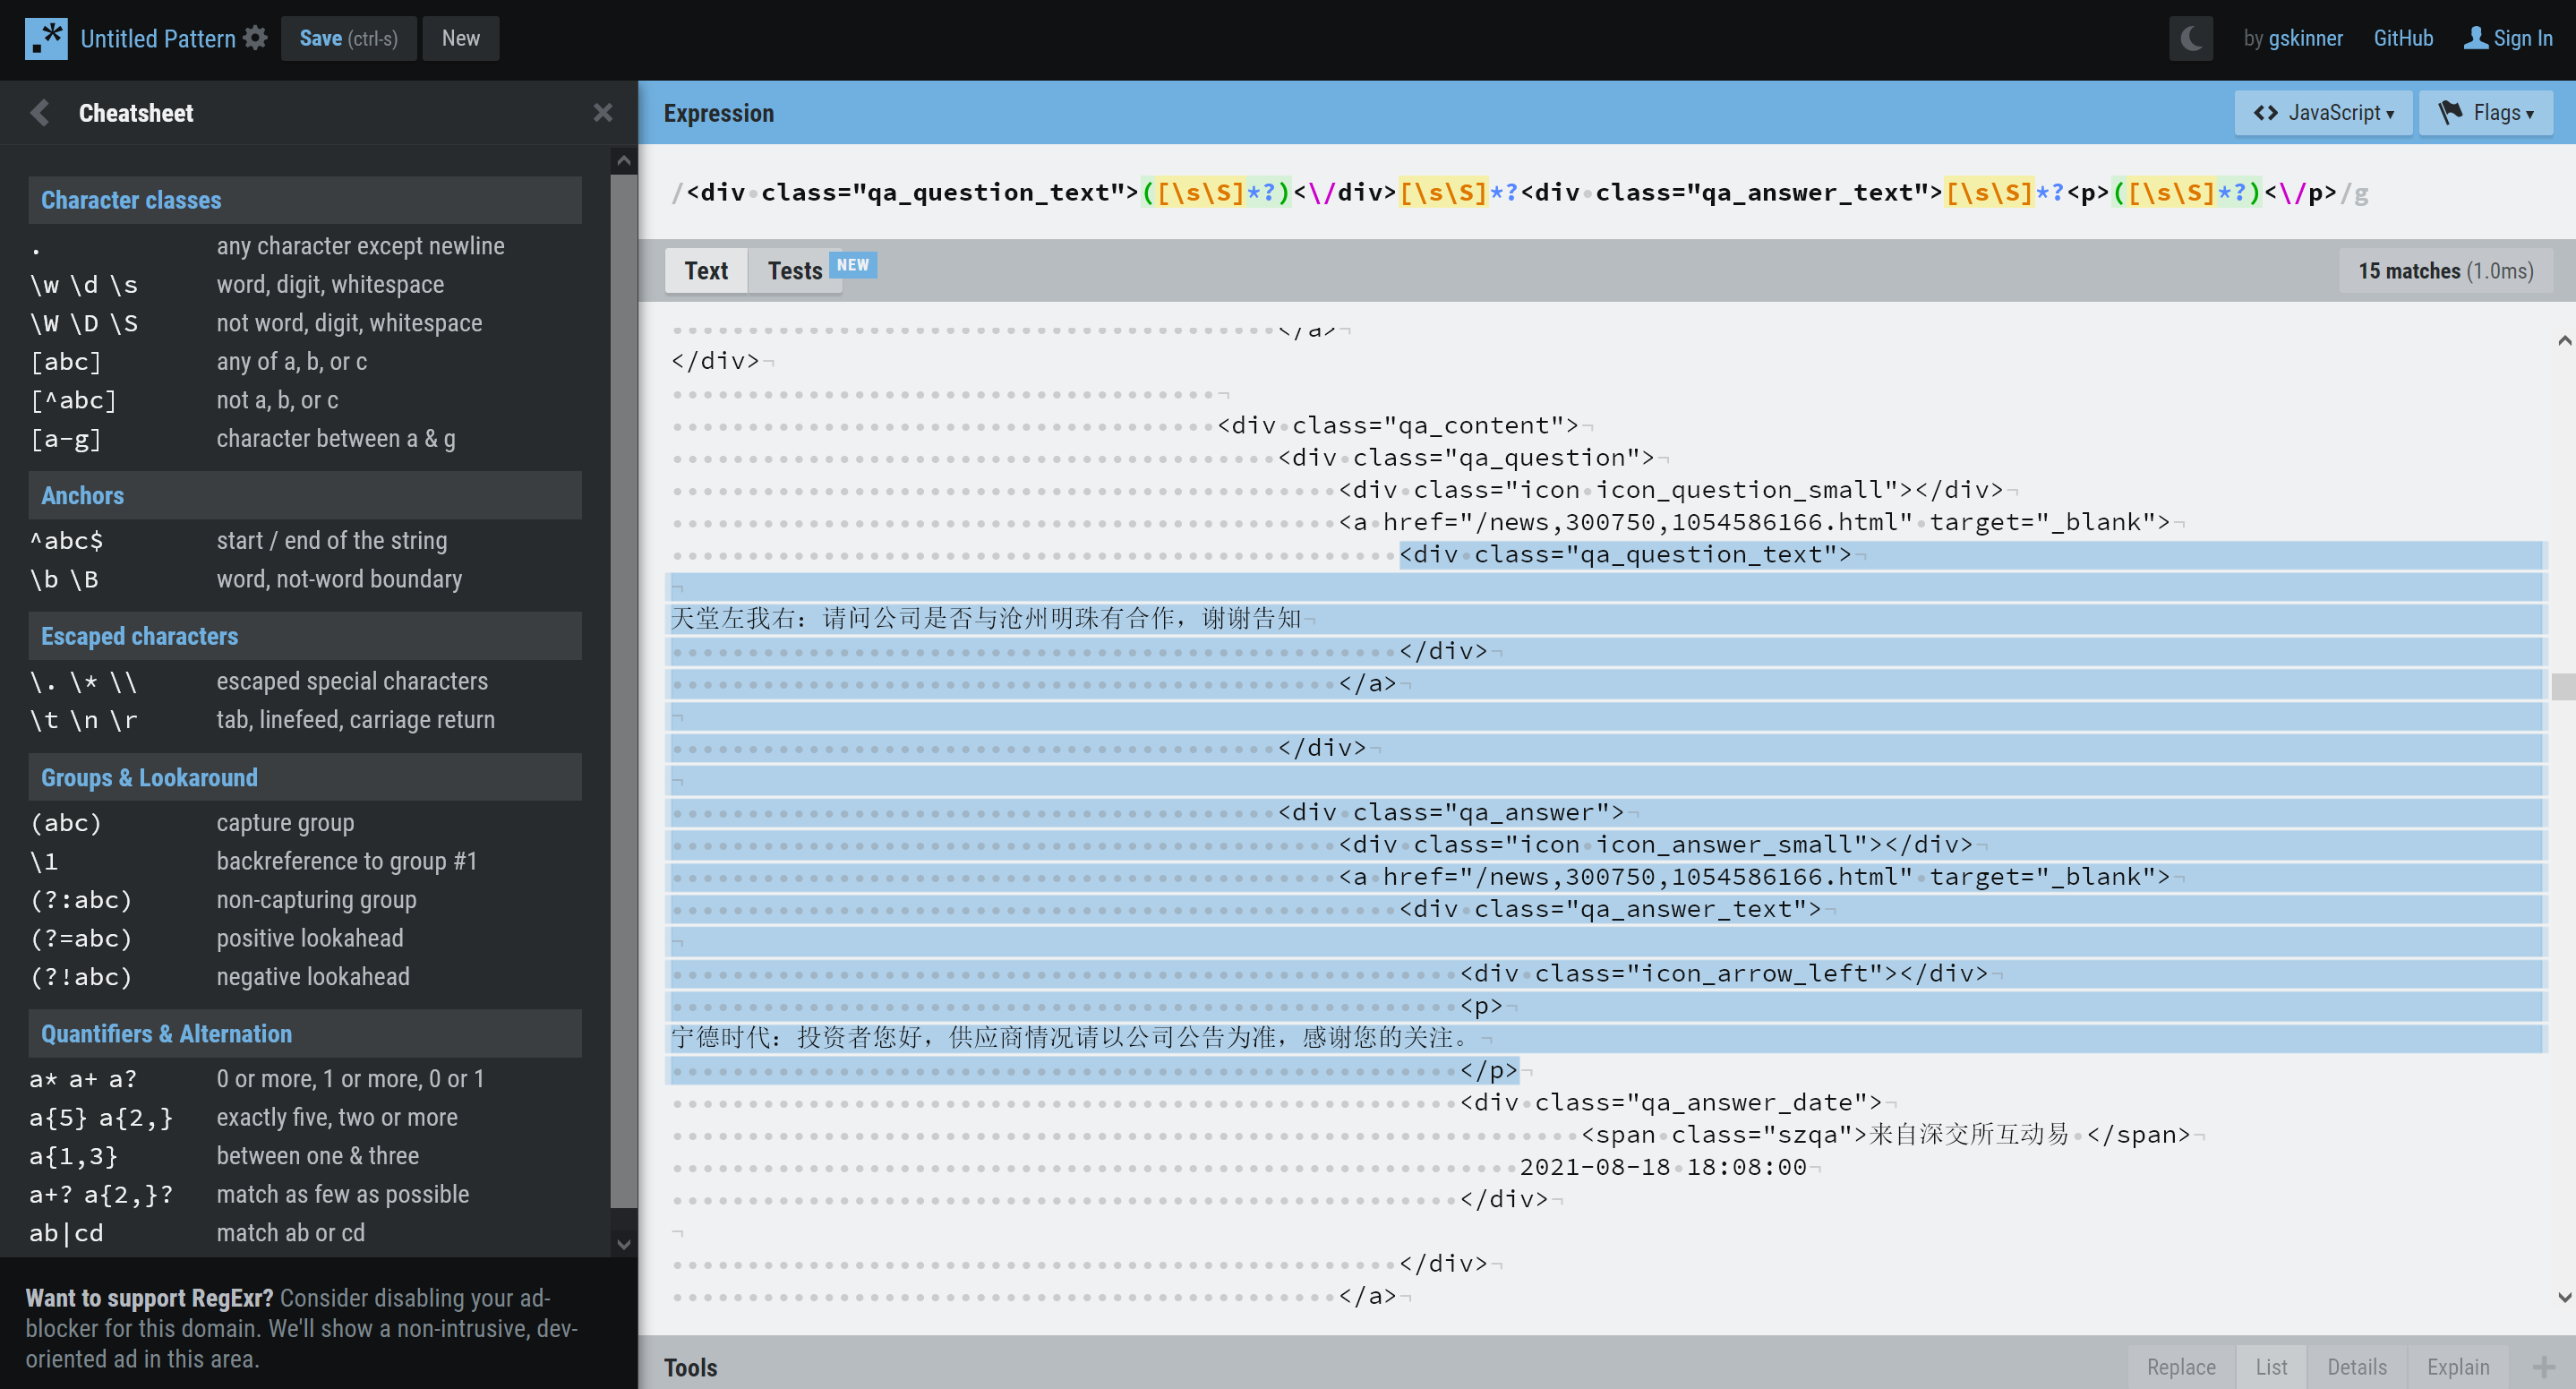
而我们在https://regexr.com/上, 在Expression一栏里填入这个正则表达式, 把最开始复制的网页源代码粘贴进下面的大空白, 然后找到了15个匹配项. 下图里, 蓝色高亮的就是其中一个匹配项.
我们来拆解这个长长的正则表达式.
<div class="qa_question_text">无需多说, 它是我们想要匹配的文本的开头, 我们希望能够精确地找到<div class="qa_question_text">.
同样地, <\/div>, <div class="qa_answer_text">, <p>, <\/p>都是我们想要精确匹配的. 我们可以把它们理解成扫描二维码时用来定位的那几个大黑块, 它们并不携带我们想要的信息, 但是我们想要的信息被包裹在其中.
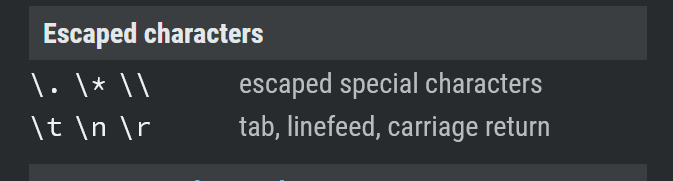
\是为了表示转义字符/(\/才能在正则表达式里表示/, 或许你不理解这一点, 但是, 看看regexr.com的侧边栏cheatsheet或许你就明白了)
可以看出, 现在, 我们的正则表达式还剩下([\s\S]*?), [\s\S]*?, [\s\S]*?, ([\s\S]*?), 而这四个有两个还是相同的, 就只剩下了([\s\S]*?), [\s\S]*?. 而它们俩的区别只是少了一对括号().
那么, [\s\S]*?在做什么事呢? 一句话总结, 它能匹配两个精确字符串之间的全部字符. 比如我们截图里这个就在匹配<div class="qa_question_text">和<\/div>之间的全部字符.
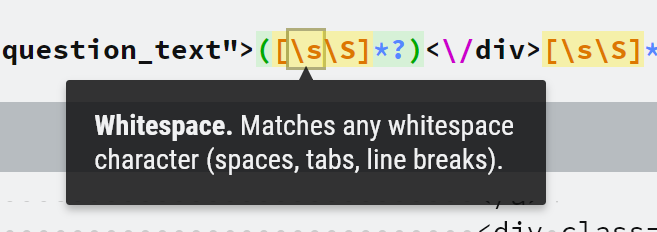
至于它具体是怎么实现的嘛, 在https://regexr.com/上, 把鼠标移动到某个正则表达式代码附近, 网站就会提示你, 用小灰框框出可以拆分的最小单元, 然后告诉你这个小单元是在做什么.
然后, 结合着右边的Cheatsheet, 你可以弄懂任何和正则表达式有关的知识!
那么, 你也能发现用()把[\s\S]*?括起来, 是为了把[\s\S]*?匹配到的字符串当作一个group来对待, 方便后续使用.
显然, 这里, 我们把股民的问题和宁德时代的回答分别括起来了.
Python的正则表达式实现
我们首先需要导入一个叫re的包, 毫无疑问, 它是regular expression的缩写.
re为我们提供了一个名为findall的函数, suggested by its name, 它能找到所有的符合条件的子串.
一般来说, re.findall接受两个参数, 就能够实现功能.
string: where to look up, here the long raw htmlpattern: the string you try and try and find satisfying in https://regexr.com/
import re
question_answer_pairs = re.findall(string=html,
                                   pattern=r'<div class="qa_question_text">([\s\S]*?)<\/div>[\s\S]*?<div class="qa_answer_text">[\s\S]*?<p>([\s\S]*?)<\/p>')
到这一步, 你已经基本上把我们想要的信息找到了. 但是用在Python Console里输出一下, 你发现, 还有小瑕疵:
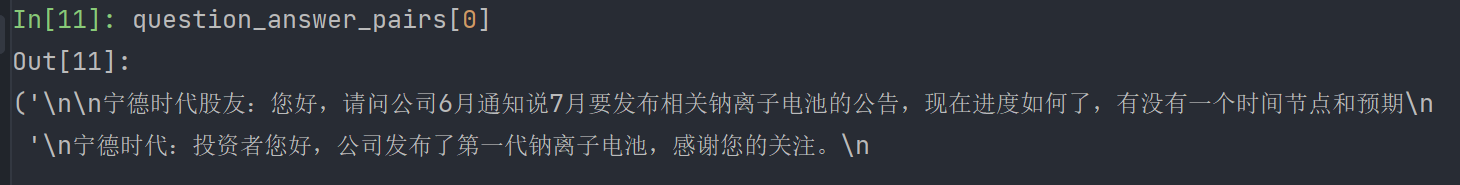
\n表示换行符, 也就是我们在word按下enter之后屏幕上出现的符号.
我们想要干净的文本, 所以我们用str自带的strip方法, 就能很方便地去掉开头和结尾的换行符:
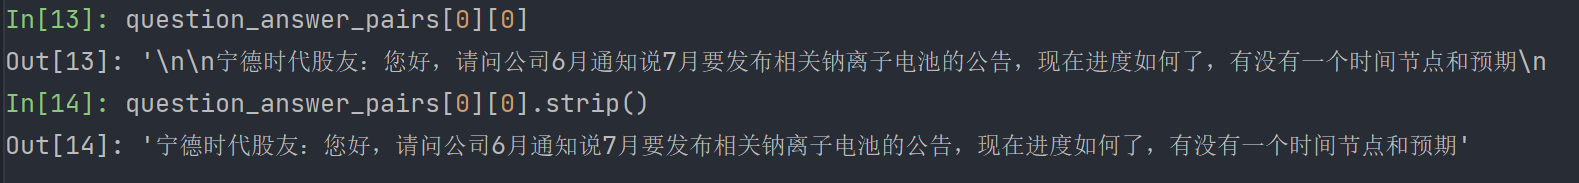
那么, 我们用list comprehension对所有的文本都来一遍:
question_answer_pairs = [(q.strip(), a.strip()) for q, a in question_answer_pairs]
到此为止, 我们已经实现了从一段原始的html文件中提取出一对对的股民与上市公司的问答.
完整代码
附上本文用到的全部代码:
import re

with open('./data.txt') as file:
    html = file.read()

# method 1: not safe
questions = re.findall(string=html, pattern=r'<div class="qa_question_text">([\s\S]*?)<\/div>')
questions = [ques.strip() for ques in questions]
answers = re.findall(string=html, pattern=r'<div class="qa_answer_text">[\s\S]*?<p>([\s\S]*?)<\/p>')
answers = [ans.strip() for ans in answers]

# method 2: better
question_answer_pairs = re.findall(string=html,
                                   pattern=r'<div class="qa_question_text">([\s\S]*?)<\/div>[\s\S]*?<div class="qa_answer_text">[\s\S]*?<p>([\s\S]*?)<\/p>')
question_answer_pairs = [(q.strip(), a.strip()) for q, a in question_answer_pairs]
未完待续
那么, 如何用爬虫来自动地获取html文件呢, 怎么样才能不用人工点击那个点击加载更多按钮呢? 我们下期见.