这篇博客解答了上一篇博客遗留的问题, 介绍了在浏览器中调试类似的数据加载网页,并讲解了如何用Python的requests库来编写代码,不断地获取网站后端返回给我们的数据。
本教程用到的技术栈:
- Python
- 文本读写
- JSON数据的处理
- 异常处理
- 模拟浏览器发送请求
- 网页
F12调试发现网页规律
本博客由果然科技有限公司独家赞助.
简介
一般来说,东方财富对每个股票都设有“问董秘”板块。通过该股票的主页,以贵州茅台为例, 点击”问董秘”即可进入贵州茅台的问董秘网站.
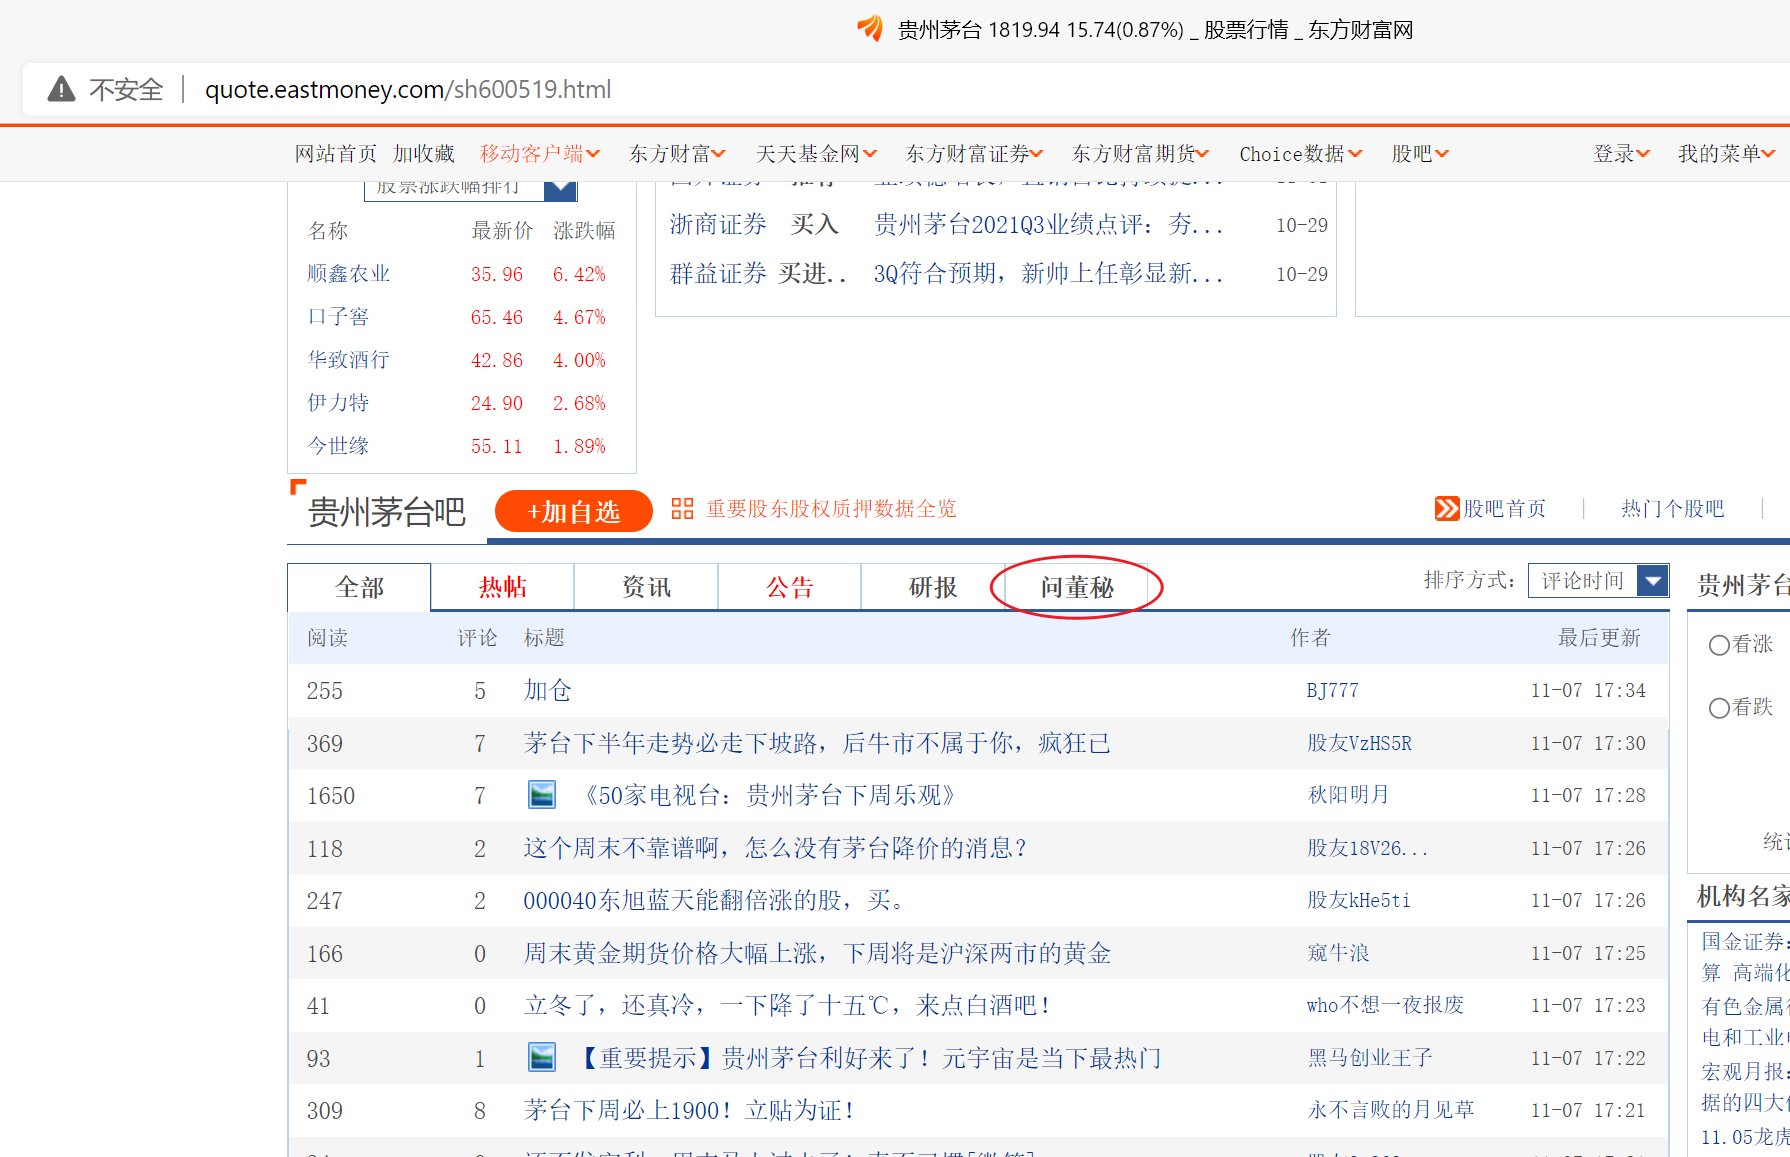
我们可以在浏览器的搜索框里看到该网站的网址.
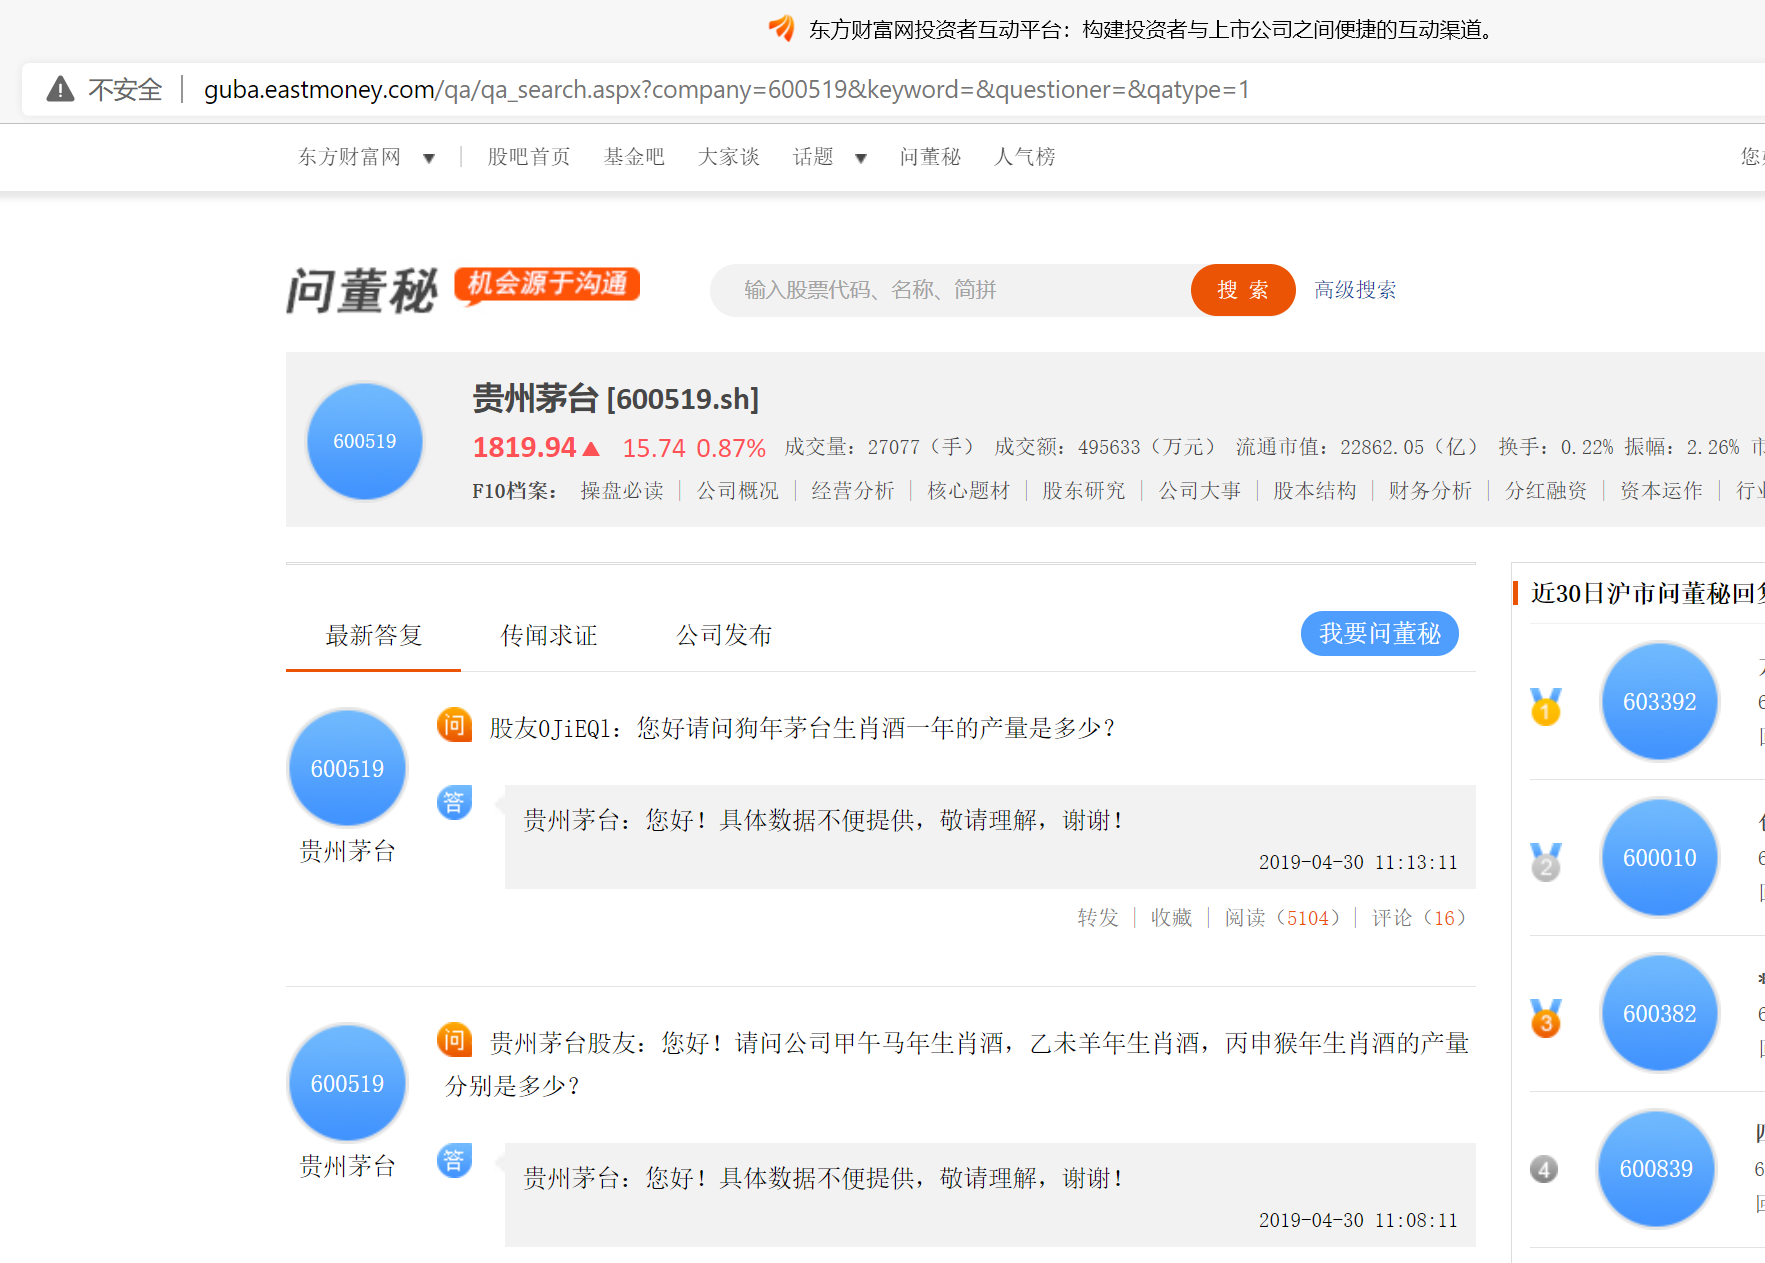
因为东方财富体量巨大, 需要对众多上市公司的信息进行维护, 我们合理地推测: 网址的链接也是有一定的规律可循的. 例如: http://guba.eastmoney.com/qa/qa_search.aspx?company=600519&keyword=&questioner=&qatype=1中的company=600519, 若是把600519换成别的公司的代码, 或许就是别的公司的问董秘板块.
当然, 这一切都是猜测. 是否是这样, 我们需要后续的调试和进一步的观察.

网页调试
打开F12, 进入调试界面. 如果没有反应, 可能是在笔记本上需要按下Fn+F12.
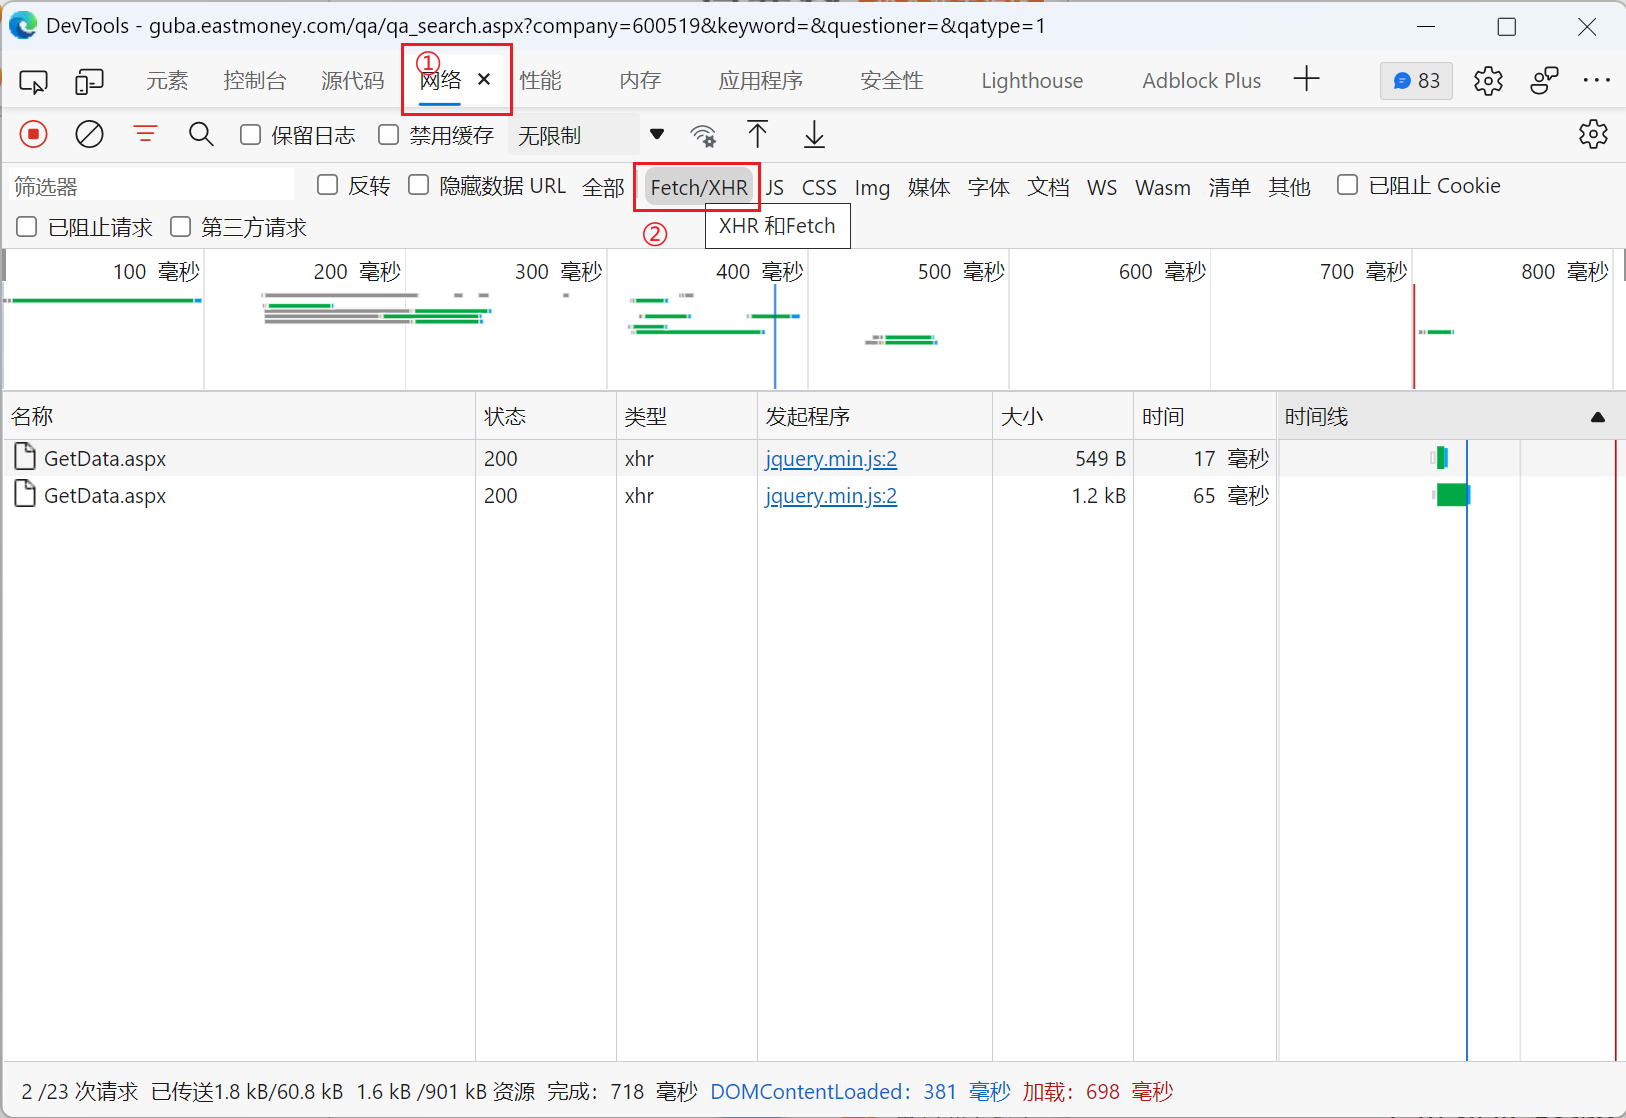
按下Ctrl+R刷新一下, 按照下图中的顺序, 找到这个界面.
请求类型
我们发现: 浏览器一共进行了两次请求, 两个请求的名称都是GetData.aspx. 我们可以随便点击一个请求, 这样在右边会弹出该请求的具体情况, 如下图所示:
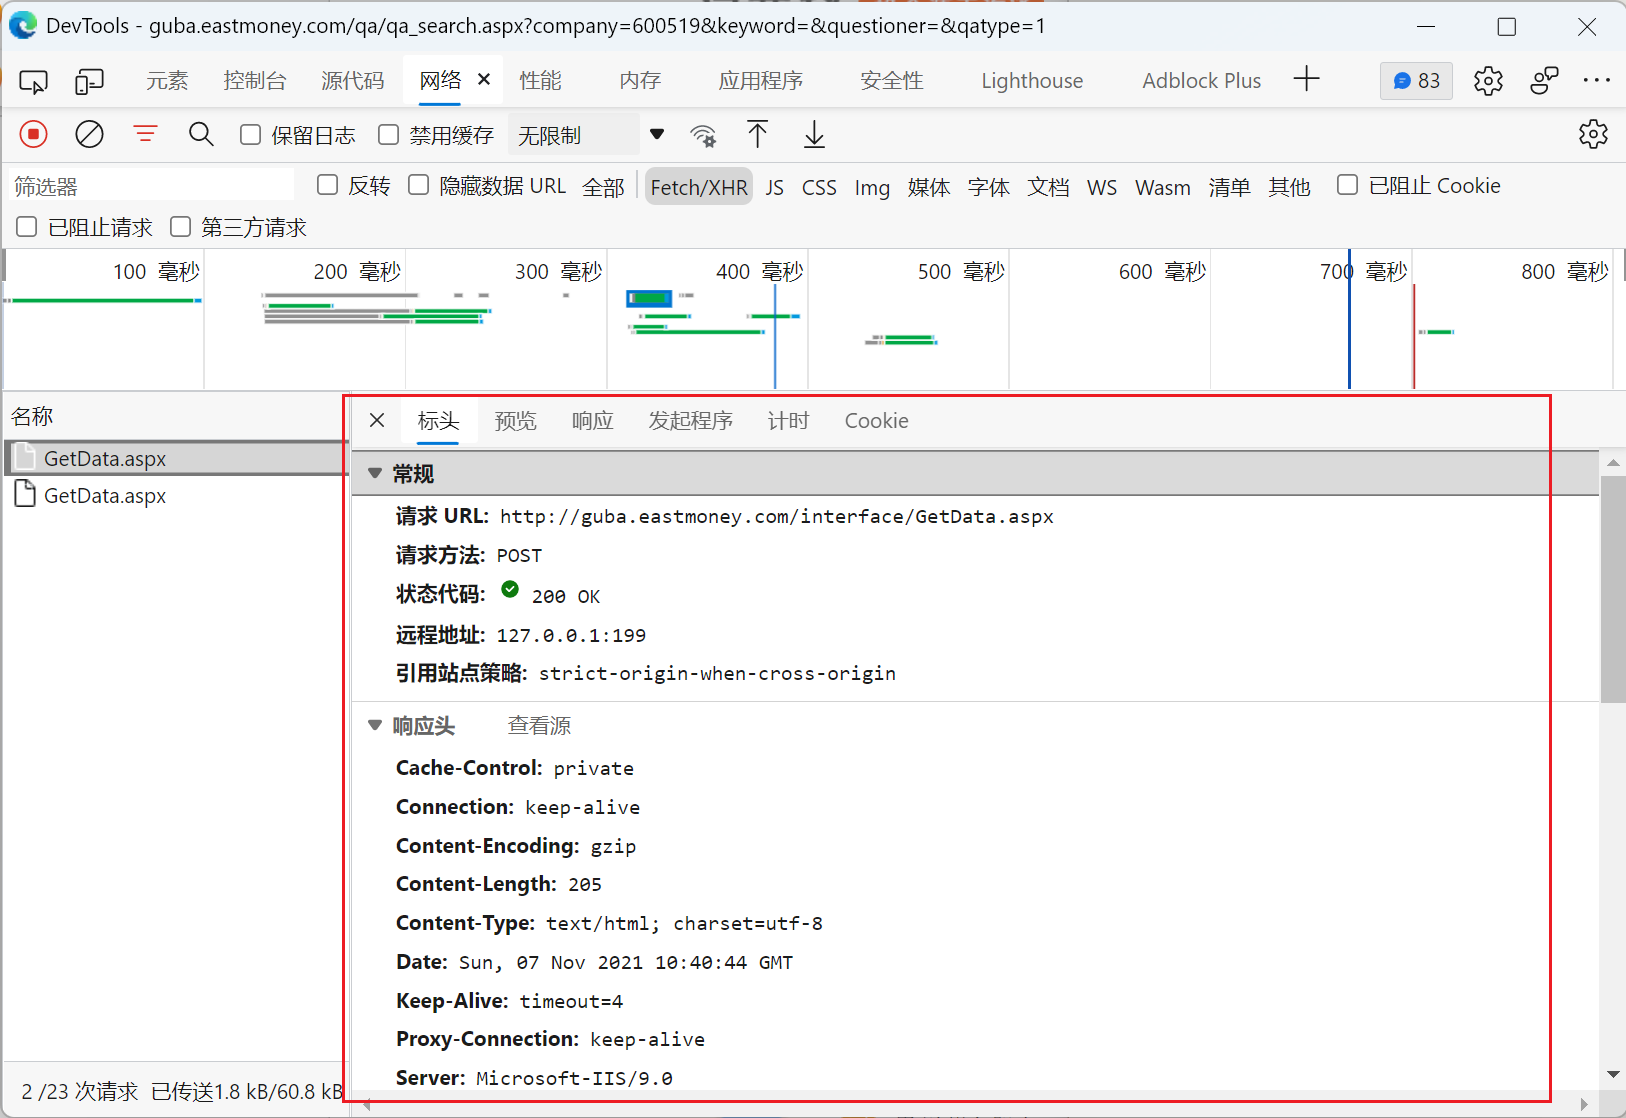
红框框起来的几项里, 包含了我们用浏览器和东方财富网站进行交互的一些参数. 例如:
- 请求的URL是:
http://guba.eastmoney.com/interface/GetData.aspx - 请求的方法是:
POST
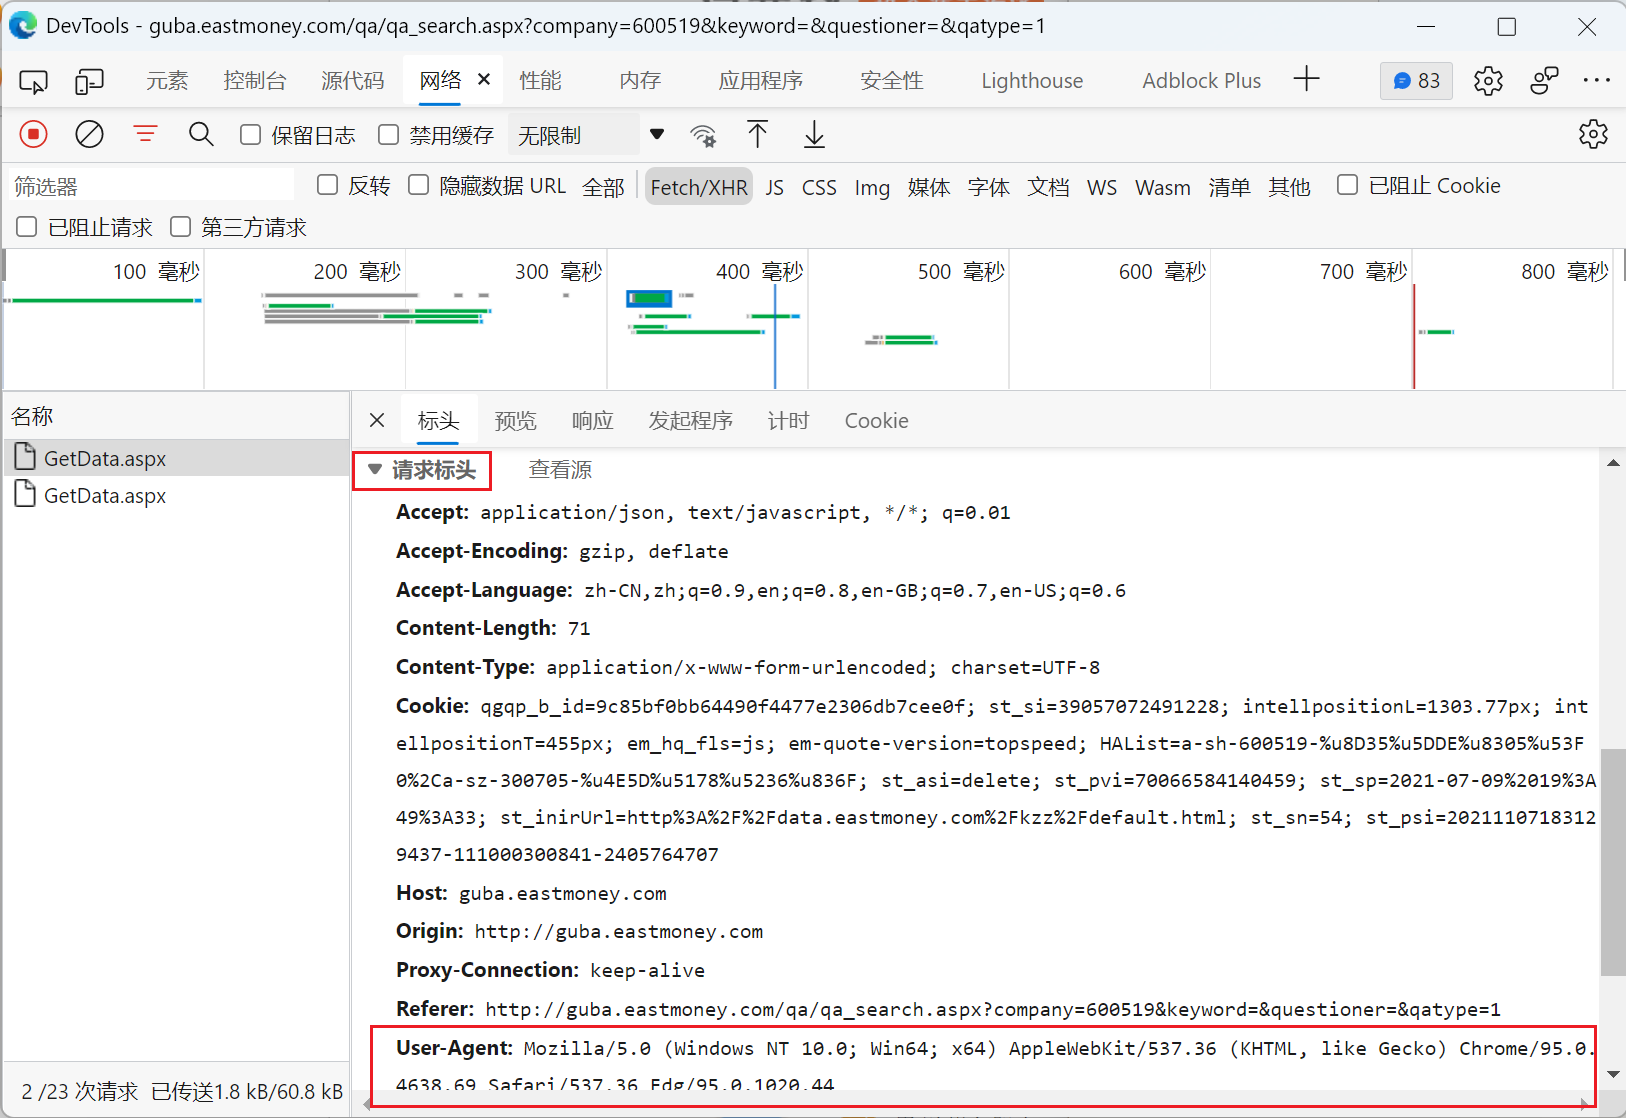
请求头 (header)
我们向下划, 找到请求标头, 我们可以看到User-Agent这一项. 它记录了你是用什么浏览器来向 http://guba.eastmoney.com/interface/GetData.aspx 这个URL进行的 POST 请求. 而上面的Referer, 在多观察了几个公司的F12页面之后, 我们发现, 针对不同的股票代码, 它的结构是http://guba.eastmoney.com/qa/qa_search.aspx?company=股票代码&keyword=&questioner=&qatype=1. 这也便于我们后续使用Python编写爬虫程序的时候, 构造Referer.
表单数据 (form data)
继续向下划, 我们找到了表单数据, 如下图所示:
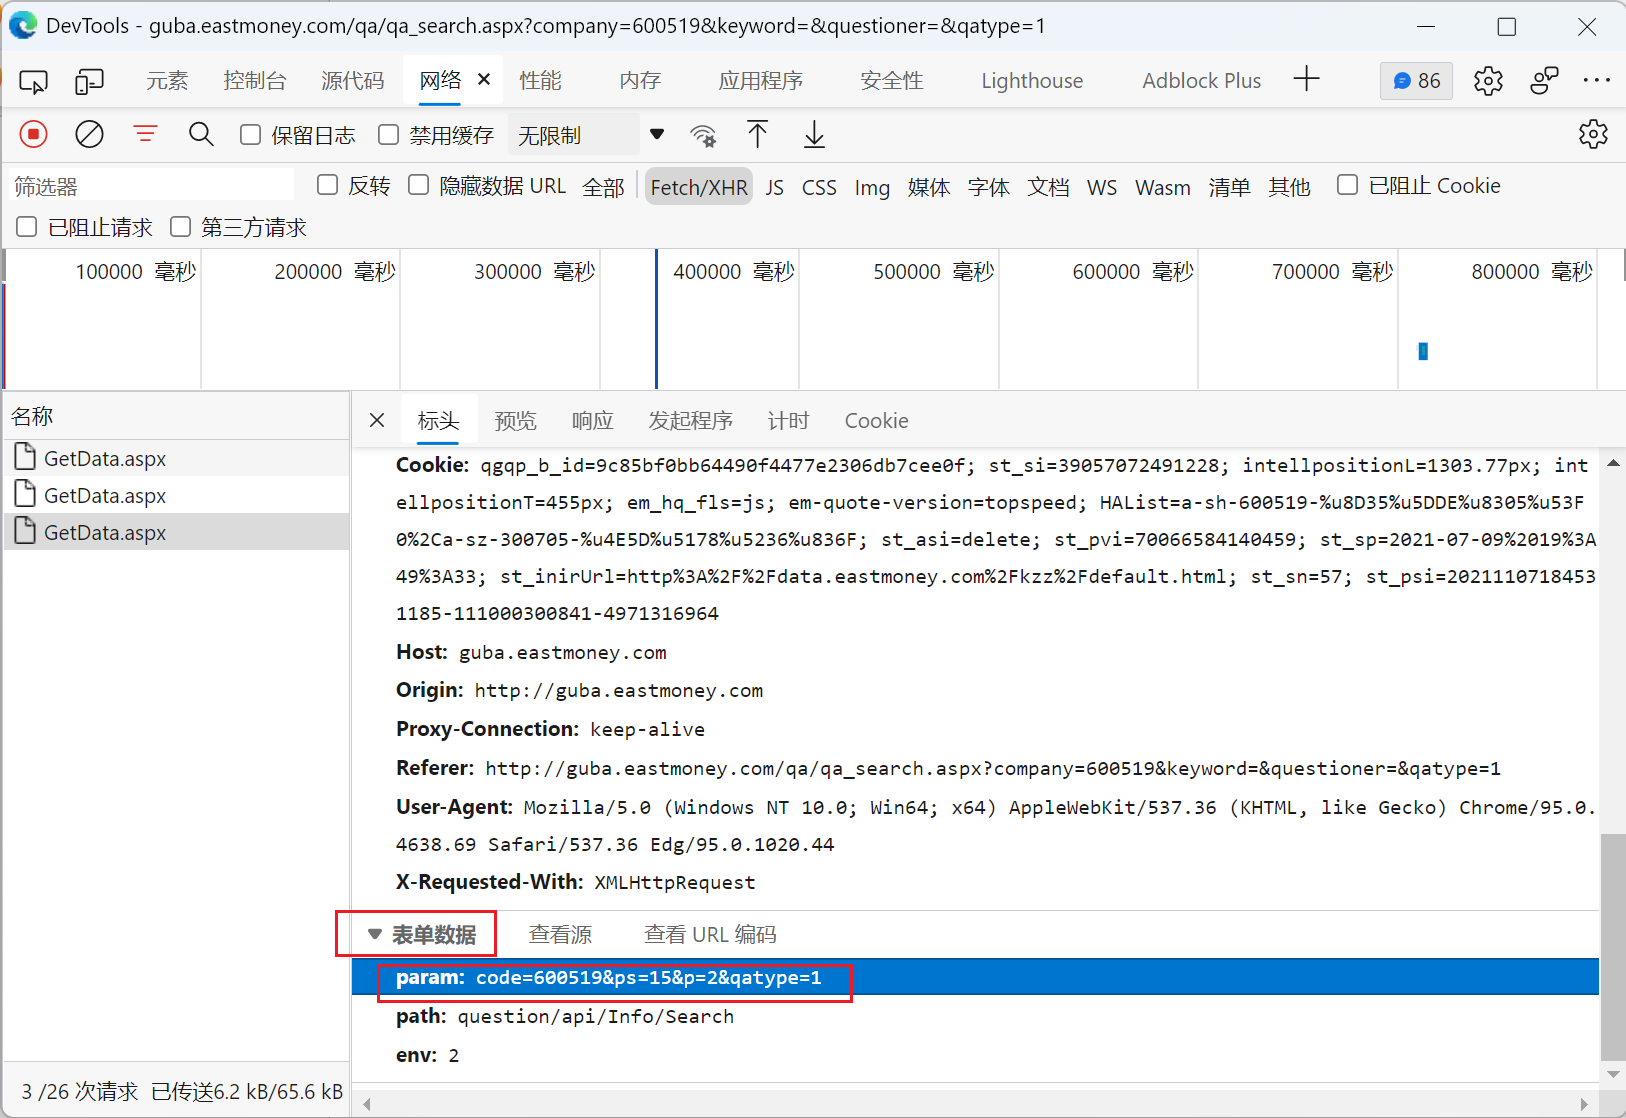
这里记录了你传递给http://guba.eastmoney.com/interface/GetData.aspx的参数. 根据我的理解, code=600519&ps=15&p=2&qatype=1中, code=600519代表你请求的股票代码, ps=15代表你请求数据的条数, 这里是15条, 也就是按下点击加载更多按钮之后, 你又向东方财富的后台请求了15条新的股东-董秘问答, 而qatype=1代表着问答的类型, 对于所有的公布出来的股东-董秘问答, 或许它们的qatype在东财后台都被标记为1. 三者用&连接起来, 则构成了完整的表单数据.
现在, 我们已经知道了, 人类用户在使用浏览器时是如何和网站后台交互的了, 现在就是教会机器用户和东财后台交互了.
简单使用requests库
构建表单数据
假设我们想让机器爬取300条问董秘的问答文本, 结合我们刚刚在表单数据-param中发现的规律, 点击一次点击加载更多, 会额外请求15条, 那么机器一共要发送20个GetData.aspx的请求. 并且每个请求的表单数据应该是:
code = 600519
for i in range(1, 21):
    data = dict(param=f'code={code}&ps=15&p={i}&qatype=1', path='question/api/Info/Search', env=2)
为什么i要从1开始呢,这也是尝试对比了从0开始和从1开始之后发现的规律.
构建头文件
而对于每一次请求, 头文件都是一样的, 可以用一个字典数据表示:
header = {
'Referer': f'http://guba.eastmoney.com/qa/qa_search.aspx?company={code}&keyword=&questioner=&qatype=1',
'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/95.0.4638.54 Safari/537.36 Edg/95.0.1020.40)'
}
发送请求
我们调用requests的post函数, 传给它url, headers, data 三个参数, 函数的返回值就是网页给我们的response.
import requests
url = r'http://guba.eastmoney.com/interface/GetData.aspx'
response = requests.post(url=url, headers=header, data=data)
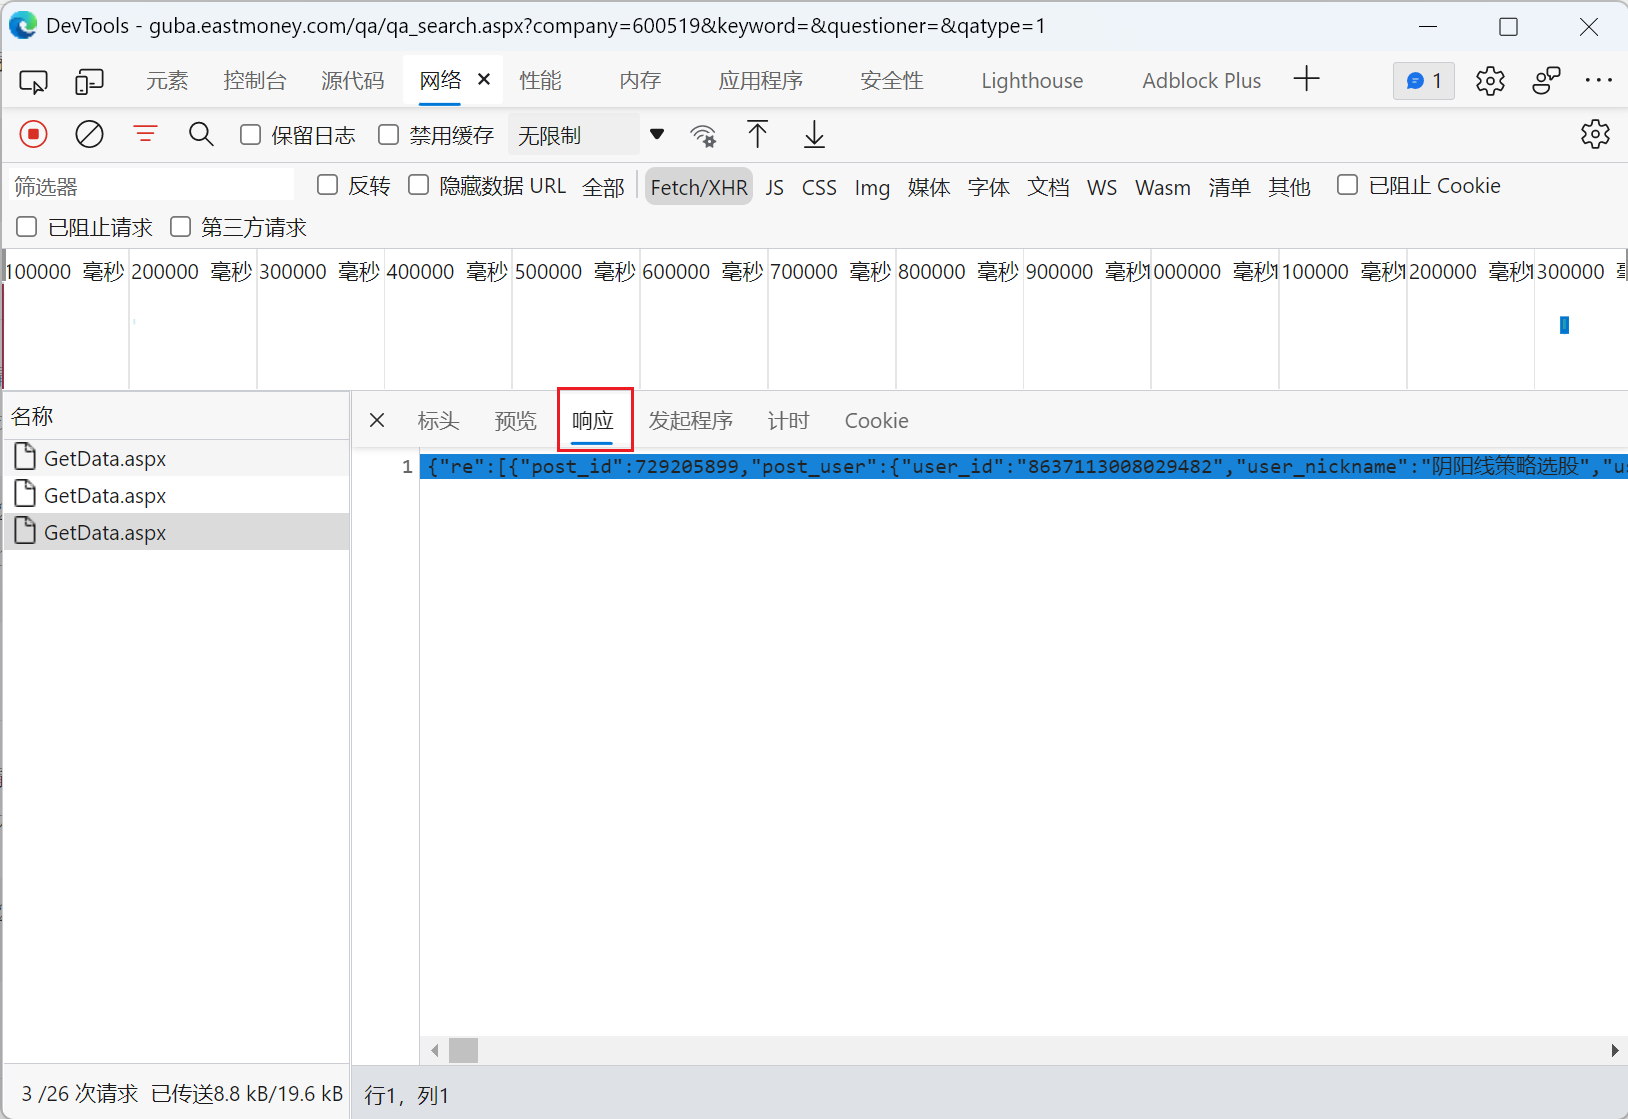
什么是网页的response呢? 在开发者工具页面 , 点击响应, 就能看到网页给我们返回了一个漂亮的json. 关于json这种数据格式, 你可以把它理解成python里的字典数据类型, 都是由一对对的key和value构成.
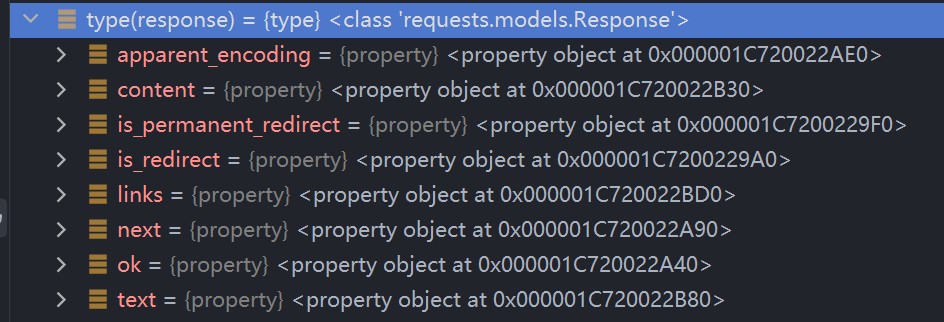
通过``type函数, 我们可以查看response` 的数据类型, 并且还能看出它包含了哪些性质, 如下图所示:
调用response的.json()方法, 我们就能得到东财返回给我们的json数据
response_json = response.json()
自我探索时间:
我们想要的”问董秘”问答文本在哪呢?
我们发现, response_json['re']返回了一个列表, 列表里的元素是一个字典, 似乎, 这就是一条条的问答帖子.
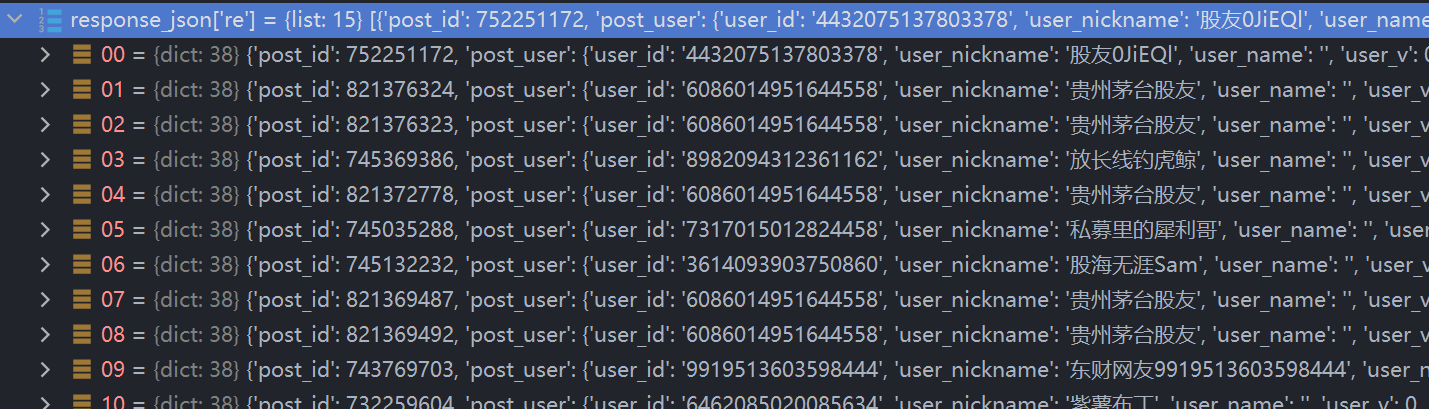
我们随便找一条继续观察:
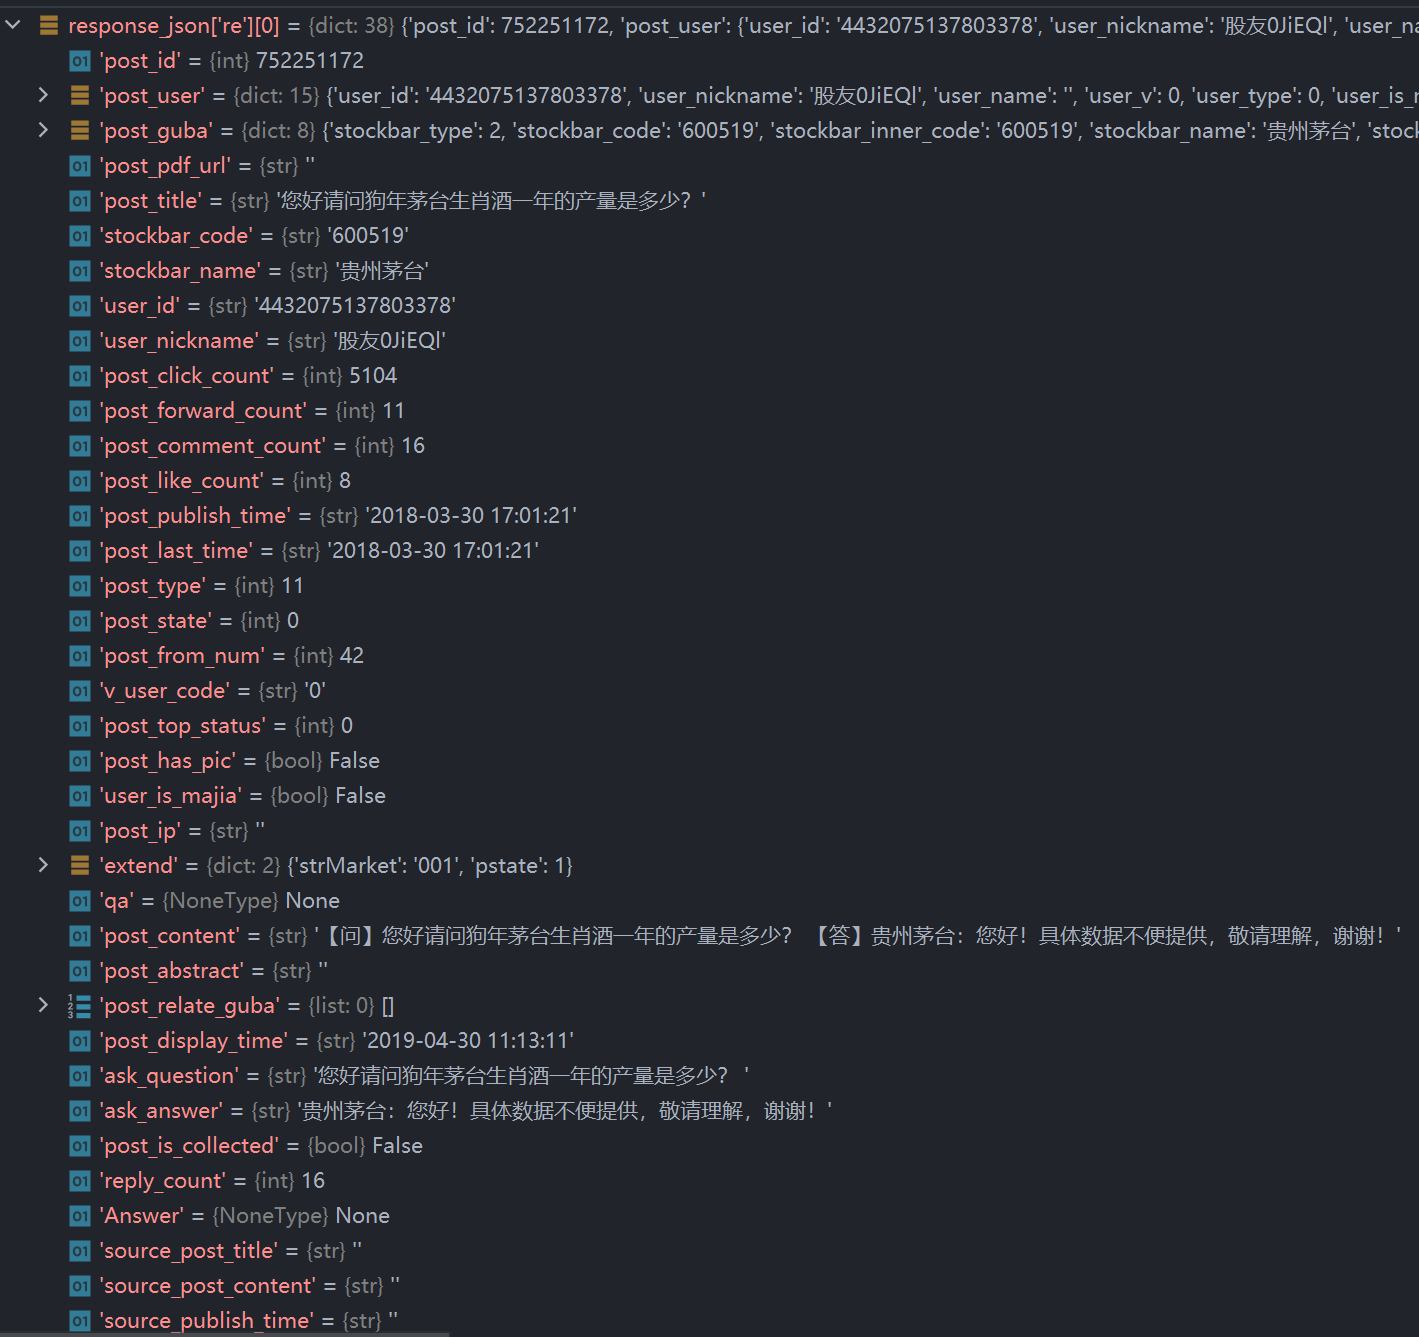
发现: post_title, user_nickname, post_content, ask_question, ask_answer里都有一定的文本信息, 并且有些重叠. 简单拼接一下, 我们就能得到一条完整的问答:
for record in response_json['re']:
    record['user_nickname'] + ': ' + record['ask_question'] + '\n' + record['ask_answer']
异常处理
拿茅台来说, 可能问董秘模块里根本没有300条问答, 那我们直接运行爬虫去爬取300条数据, 就会遇到错误, 而错误会导致程序的中断.
一个比较保险的做法是:
try:
    our_crawling_code
except:
    pass
而一个习惯更好的方法是在except后面指定错误类型, 我们推测, 在后台没有数据返回时, response_json['re']可能返回空列表[], 那么显然它会造成IndexError. 把异常处理的异常部分写得更具体:
try:
    our_crawling_code
except IndexError:
    pass
总结
到这里为止, 我们就完成了从调试网页到编写爬虫程序的一条龙. 很自然地我们希望把上述过程打包成为一个函数, 函数接受上市公司的股票代码作为输入, 输出爬下来的”问董秘”问答文本. 具体代码如下
全部代码
下列代码可能不是最新的,但也能正常运行,最新代码请参见Github
import os
import requests

url = r'http://guba.eastmoney.com/interface/GetData.aspx'


def get_question_answer_pairs(code):
    if not os.path.exists('./output'):
        os.makedirs('./output')

    with open(f'./output/{code}.txt', mode='w') as f:
        f.write('')
    for i in range(1, 21):
        data = dict(param=f'code={code}&ps=15&p={i}&qatype=1', path='question/api/Info/Search', env=2)

        header = {'Referer': f'http://guba.eastmoney.com/qa/qa_search.aspx?company={code}&keyword=&questioner=&qatype=1',
                  'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/95.0.4638.54 Safari/537.36 Edg/95.0.1020.40)'}

        response = requests.post(url=url, headers=header, data=data)

        response_json = response.json()
        with open(f'./output/{code}.txt', mode='a') as f:
            for record in response_json['re']:
                try:
                    f.write('发表时间(publish time): ' + record['post_publish_time'] + '\t' + '展示时间(display time): ' + record['post_display_time'] + '\n')
                    f.write(record['user_nickname'] + ': ' + record['ask_question'] + '\n')
                    f.write(record['ask_answer'] + '\n'*2)
                except IndexError:
                    pass


if __name__ == '__main__':
    code = 600519
    get_question_answer_pairs(code=code)